InfiniSplat v2:从任意视角前馈重建三维高斯场景的分析与改进
InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
论文诊断了前馈式三维高斯泼溅(3D Gaussian Splatting,用一堆带位置与外观属性的高斯椭球表示场景)在任意视角输入下渲染模糊、飞点的成因,并用冻结几何分支、真值相机尺度对齐与大角度目标视角监督三项改动提升大视角变化下的新视角渲染质量。
问题与背景
基于图像的场景重建目标是从输入图片得到可渲染的三维场景,用于模拟、内容创作与自动驾驶等。三维高斯泼溅以显式高斯表示实现高效渲染;近年的前馈方法则直接从图像预测高斯场景,免去推理时的逐场景优化。多视图几何基础模型(如 Depth Anything 3,简称 DA3)能预测每张输入视图的深度与相机,把深度反投影到统一坐标系即可得到点云。
该点云整体几何连贯,但常含空间上孤立、跨视图不一致的簇,三维聚合后尤为明显。已有前馈方法(如 DA3-GS 在 DA3 几何之上学习高斯属性)的渲染仍存在模糊、重影与细节缺失。论文要回答的是:如何用这些不完美的几何预测,构建能支撑高质量新视角渲染的高斯场景。
核心思路
论文把问题定位在「高斯属性学习」而非几何预测本身。它发现三件事:一是几何与属性联合优化会让位置去补偿属性误差,导致几何退化并产生飞点;二是训练时用预测相机位姿反投影会引入位姿误差,在大角度监督下误导网络;三是只在输入视角附近监督,会让高斯的尺度与朝向约束不足。
对应地,作者冻结几何分支、只用可训练分支学习不透明度、尺度、旋转与颜色,并把高斯中心固定在反投影点上;用真值相机(经尺度对齐)同时做反投影与渲染监督;再用偏向大角度差的目标视角做监督。此外,一个学习式精修器以输入视角的渲染梯度为输入,迭代更新属性而保持中心不动。
方法如何工作
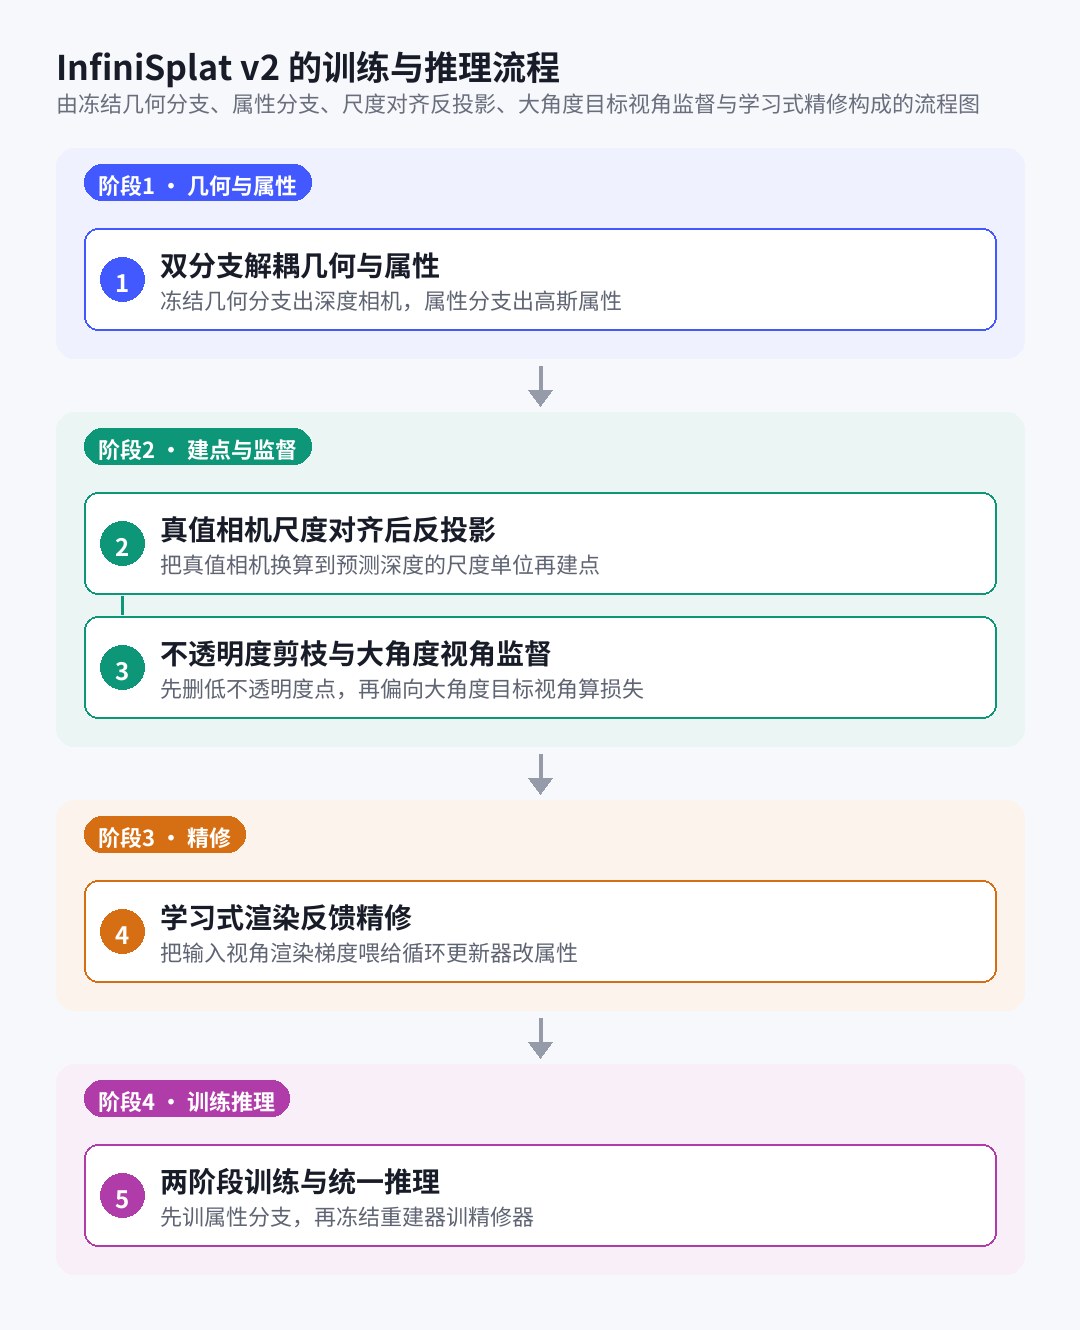
双分支解耦几何与属性
两分支用同一份预训练 DA3 权重独立初始化。冻结的几何分支 Φ_geo 输出深度与相机;属性分支 Φ_attr 只微调最后 K 个 Transformer 块,再由 DPT 式高斯解码器输出逐像素属性。点由反投影得到,不预测位置偏移,尺度与旋转保持可学,以便调整高斯形状。
真值相机尺度对齐后反投影
先用平均径向距离归一化 定义预测重建的尺度单位,预测深度与相机平移同除该值。再用 Umeyama 从真值输入相机中心到归一化预测相机中心拟合相似变换,只保留其尺度 去缩放真值平移,内参与参考系相对旋转保持不变。随后用尺度对齐的真值相机反投影归一化深度得到候选中心,并按体素策略合并冗余点。
不透明度剪枝与大角度视角监督
合并后剪掉不透明度低于 的高斯得到初始场景。目标视角按与最近输入视角光轴夹角 排序,偏向大角度采样,使尺度与朝向在不同方向的投影下受约束。
目标视角的损失由真值深度 warp 掩码限制在至少一个输入视角深度一致的区域;目标图像与相机只用于采样和监督。
学习式渲染反馈精修
从初始场景出发,把场景渲染到全部输入视角,聚合重建损失对高斯属性的梯度,停梯度后与当前场景、投影的 DPT 特征一起送入编码器,得到逐高斯特征。共享的循环 KNN Transformer 聚合邻居特征,预测属性残差与下一步隐状态;中心与数量固定,因此空间 KNN 图可跨步复用。渲染梯度是学习更新的输入,而非直接做梯度下降。
两阶段训练与统一推理
第一阶段两分支都接收 RGB 与真值位姿条件,用等权掩码 与 LPIPS 监督输入与采样目标视角渲染,只更新属性分支最后 K 块与高斯解码器。第二阶段冻结重建器,训练特征投影与精修器,输入视角损失提供反馈,输入与不相交目标视角监督更新后的场景。推理时同一模型支持有位姿与无位姿两种设置。
一个例子(帮助理解,非原文实验)
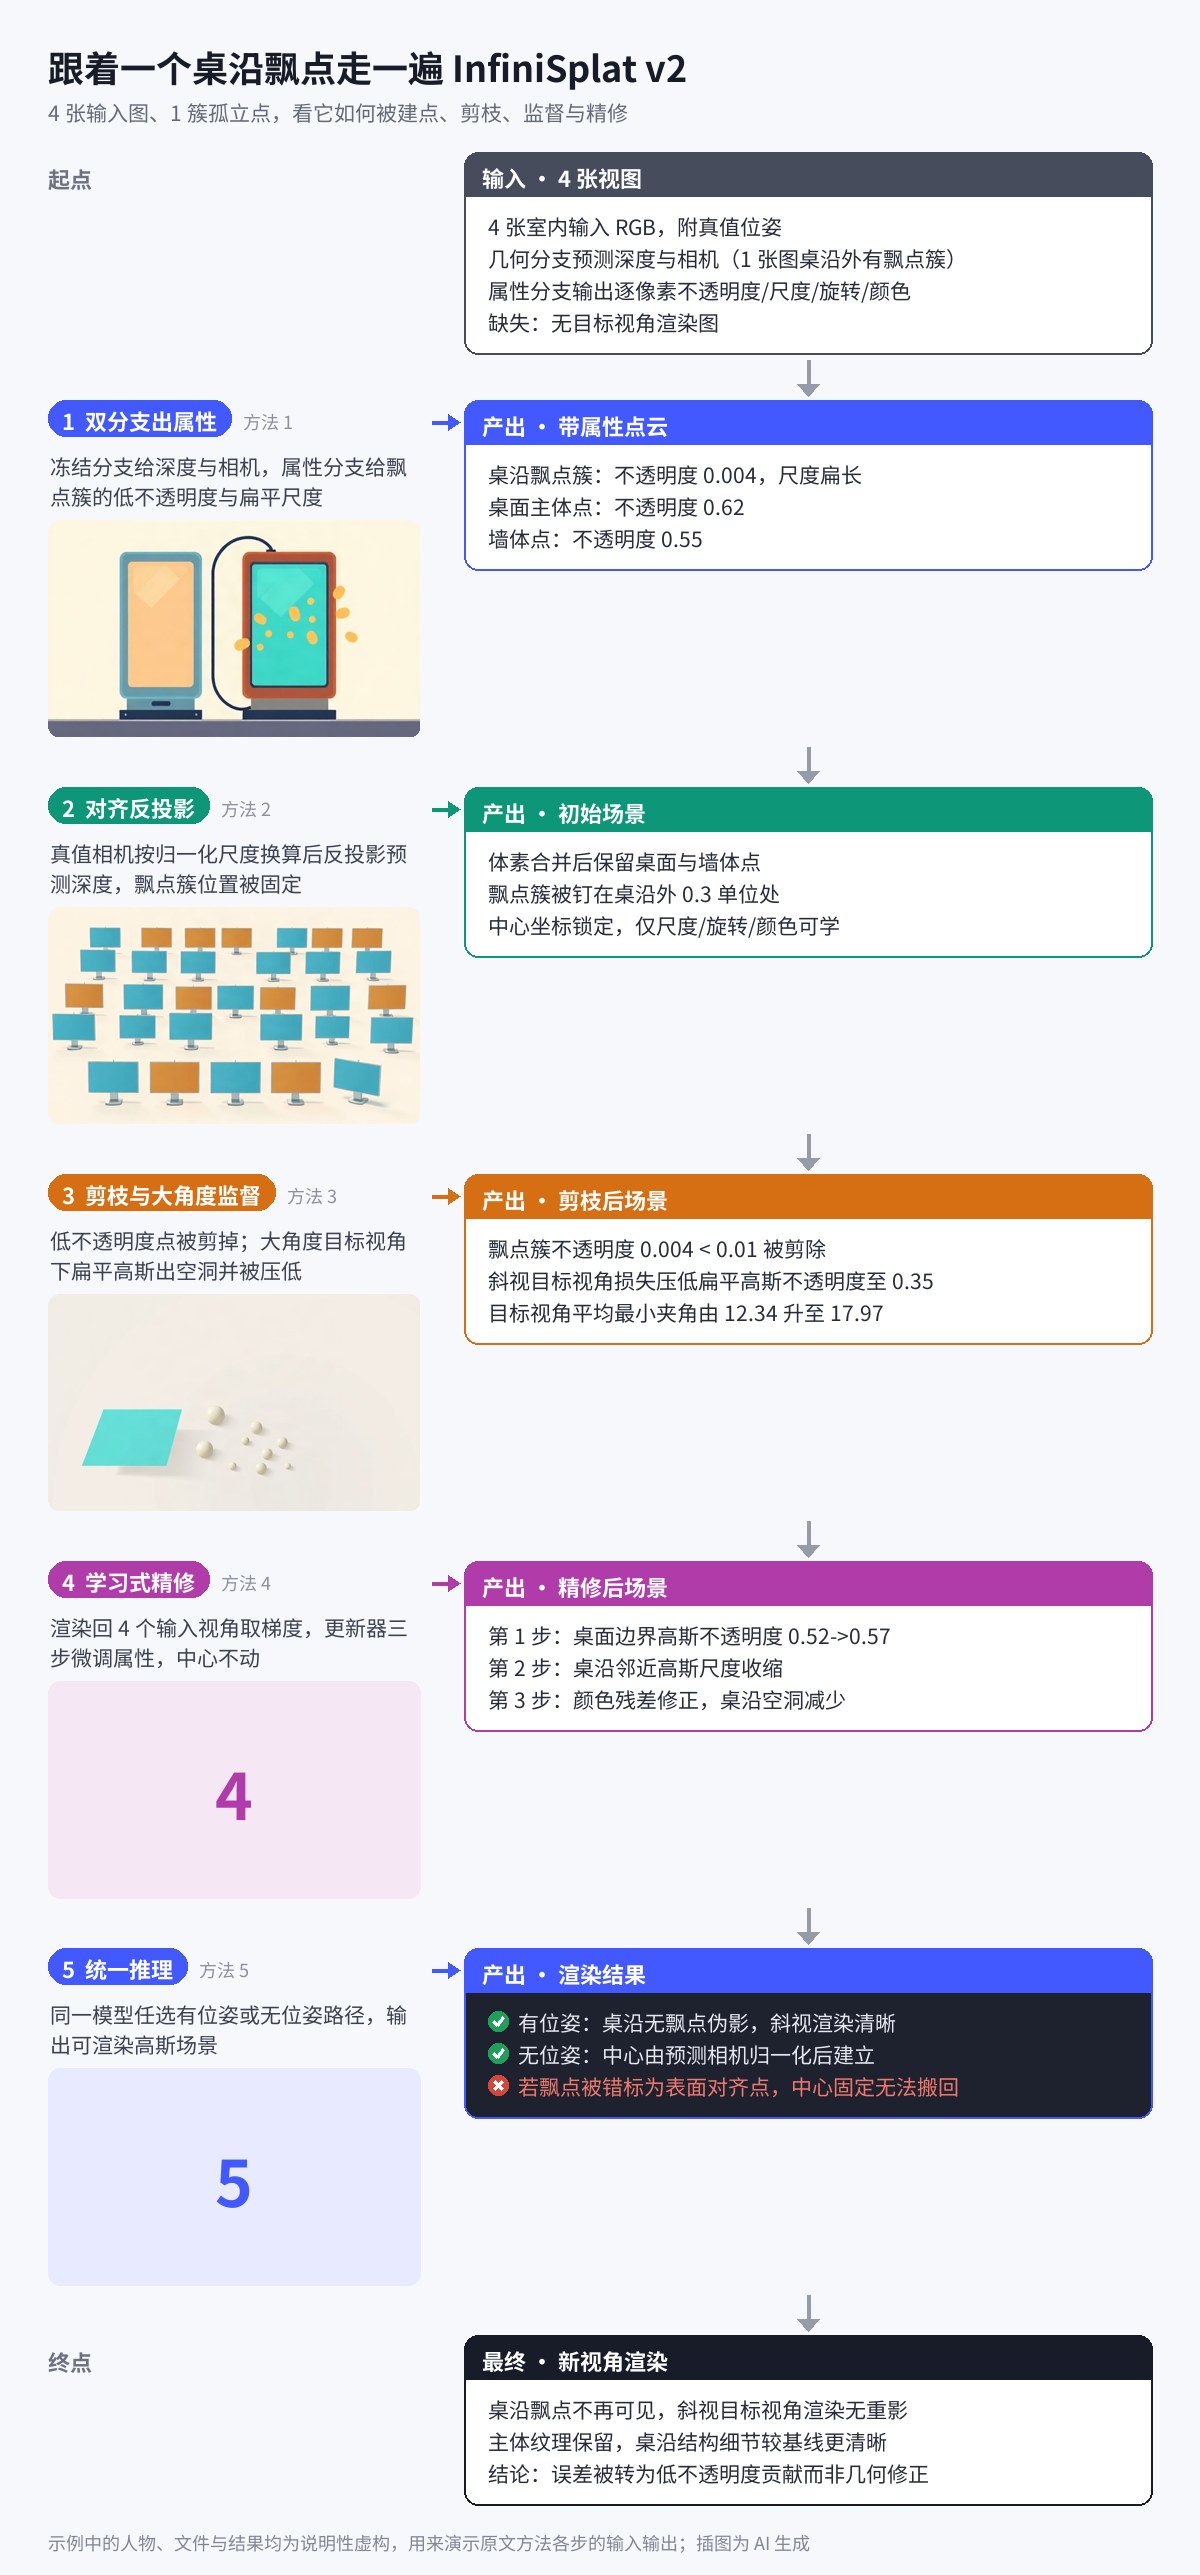
以下为说明性示例,不是原文实验。设某场景给 4 张输入图,冻结几何分支预测出深度与相机,但其中一张图的点云在桌沿外飘出一簇孤立点。属性分支为每个点给出不透明度、尺度、旋转与颜色,合并体素后,飘出点的不透明度低于 0.01 被剪掉,初始场景保留主体。
训练时用真值相机(换算到预测深度尺度)反投影建点,再选一个与最近输入光轴夹角较大的目标视角渲染:若某高斯尺度过扁,从这个斜方向看会出现明显空洞,损失就会压低其不透明度或调整尺度朝向;而只在输入视角附近监督时,这类扁平高斯几乎看不出来。精修阶段把场景渲染回 4 个输入视角,计算梯度并停梯度后送入更新器,三步后该高斯的不透明度与颜色被微调,桌沿飘点贡献进一步降低。
需要注意:原始点云错误过大时,中心不动意味着无法搬回正确位置,这部分误差只能靠压低不透明度掩盖。
证据与实验
- 在 Hypersim、Raw3D、ScanNet++ 混合数据上训练,在 DL3DV、ETH3D、NRGBD、Mip-NeRF 360、RE10K、DTU 六个数据集上评测,输入视角取 4、8、16,每例四个留出目标视角,全部方法共用同一视角划分。
- 与 tttLRM、AnySplat、C3G、DA3-GS、DepthSplat、QuerySplat、ReSplat、TokenGS、VolSplat、WorldMirror 2.0 比较。同一模型前馈输出在两种位姿设置下均取得最低平均 LPIPS 与 DISTS:有位姿时 LPIPS 较 ReSplat 降 25.8%,DISTS 较 WorldMirror 2.0 降 32.9%;无位姿时分别降 19.5% 与 30.7%。
- 在 ETH3D 与 DTU 上做消融(取精修前、N=4/8/16 平均):去掉几何冻结使两数据集 LPIPS 分别升 16.6% 与 23.2%,改用预测相机反投影使 DTU LPIPS 升 36.1%,学习位置偏移与去掉大角度监督均变差。
- 不透明度分析:在 Hypersim 验证场景用真值深度独立标注几何不一致点,阈值 0.01 剪枝去掉 51.8% 的不一致点,但只去掉全部点的 7.5%,保留 93.3% 表面对齐点。
- 精修对照:ETH3D 上三步学习精修使 PSNR 提升 0.64 dB,而三步 Adam 仅提升 0.02 dB,其余三项指标学习精修也更优;另报告了输入分辨率与前馈网络延迟的关系。
| 指标 | 本文 | 对比/基线 | 数据集 | 条件 | 单位 | 来源 |
|---|---|---|---|---|---|---|
| Mean LPIPS(有位姿,六数据集平均) | 0.2472 | 0.3333(ReSplat) | DL3DV/ETH3D/NRGBD/Mip-NeRF 360/RE10K/DTU 平均 | pose-conditioned,前馈输出,N=4/8/16 平均 | — | §4.2 Comparison with State-of-the-Art Methods「With pose conditioning, LPIPS improves b」 |
| Mean DISTS(有位姿,六数据集平均) | 0.1163 | 0.1734(WorldMirror 2.0) | 六数据集平均 | pose-conditioned,前馈输出 | — | §4.2 Comparison with State-of-the-Art Methods「DISTS by 32.9% over WorldMirror 2.0」 |
| Mean LPIPS(无位姿,六数据集平均) | 0.3026 | 0.3757(WorldMirror 2.0) | 六数据集平均 | pose-free,前馈输出 | — | §4.2 Comparison with State-of-the-Art Methods「without poses, the gains over WorldMirro」 |
| Mean DISTS(无位姿,六数据集平均) | 0.1341 | 0.1935(WorldMirror 2.0) | 六数据集平均 | pose-free,前馈输出 | — | §4.2 Comparison with State-of-the-Art Methods「without poses, the gains over WorldMirro」 |
| DTU LPIPS(消融,去掉真值相机反投影) | 0.2070 | 0.3237(w/o C) | DTU | 精修前,N=4/8/16 平均 | — | §4.3 Ablations and Analysis「GT-camera backprojection reduces DTU LPI」 |
| LPIPS(消融,去掉几何冻结) | 0.4339(ETH3D)/0.2070(DTU) | 0.5204(ETH3D w/o G)/0.2695(DTU w/o G) | ETH3D、DTU | 精修前,N=4/8/16 平均 | — | §4.3 Ablations and Analysis「Freezing geometry instead of fine-tuning」 |
| LPIPS(消融,去掉大角度监督) | 0.4339(ETH3D)/0.2070(DTU) | 0.4533(ETH3D w/o V)/0.2295(DTU w/o V) | ETH3D、DTU | 精修前,N=4/8/16 平均 | — | §4.3 Ablations and Analysis「Large-angle target view supervision impr」 |
| 几何不一致点剪枝比例 | 51.8% | 7.5%(全部点中被剪比例) | Hypersim 验证场景 | 不透明度阈值 0.01 | % | §4.3 Ablations and Analysis「pruning removes 51.8% of geometrically i」 |
| ETH3D PSNR(三步精修 vs Adam) | 17.6074(Ours∗) | 16.9890(Ours + Adam) | ETH3D | N=4/8/16 平均,三步更新 | dB | §B.3 Learned Refinement versus Direct Gradient Descent「Learned refinement and Adam improve PSNR」 |
| 前馈网络延迟(1022×756,8 输入视角) | 5.619 | — | ETH3D 单场景 | 单张 H20,五次同步测量均值 | s | §B.5 Input Resolution and Feed-Forward Network Latency「1022 \times 756 5.619 5.617–5.621」 |
各行数值来自标注章节的原句,以原文为准。
适用场景与局限
适合输入视角数量与分布不受控、且要求单次前馈即可出场景的场景:稀疏到较多视图(实验覆盖 4 至 16,附录展示 12 至 64 输入视角)的新视角合成,有位姿与无位姿两种条件共用同一训练模型,无需推理时逐场景优化。
由于不透明度剪枝能把跨视图几何不一致的点压下去,对几何基础模型预测含较多离群点的真实采集数据有直接价值;文中还在 KITTI 长街景上用滑窗构建大规模高斯场景,说明可用于自动驾驶与街景类应用的原型。需要高保真、几何精确(而不仅是渲染好看)的用途要谨慎:中心固定意味着预测几何本身的严重错误无法被修正。
对算力敏感部署也可参考其延迟数据,分辨率从 1022×756 降到 378×280 时前馈模块从约 5.6 秒降到约 0.56 秒。
- 固定中心无法纠正预测几何中的严重错误,重建质量仍受几何先验限制。
- 像素对齐预测产生冗余,体素合并无法完全去除;输入覆盖不足会在未观测区域留下空洞。
- 作者提出未来方向为更强的几何先验、更紧凑的高斯表示,以及用生成模型与相机轨迹设计缓解覆盖不足。
- 大角度目标视角与真值深度掩码的训练依赖带真值位姿与深度的数据,合成与室内扫描数据占训练主体,真实室外场景的收益尚需更多验证。(解读者观点)
- 不透明度剪枝也剪掉了 7.5% 的全部点,其中可能包含少量真实结构;论文只报告了表面对齐点的保留率。(解读者观点)
结论与来源
论文在六个数据集、有位姿与无位姿两种设置下,用同一训练模型的前馈输出取得最低平均 LPIPS 与 DISTS;作者把收益归因于固定中心加属性适配、真值相机尺度对齐反投影、以及大角度目标视角监督,ETH3D 与 DTU 的消融支持这三点。作者还报告:仅用图像重建监督学习到的不透明度会优先压低跨视图几何不一致的点。
需要区分的是,上述为作者结论;解读上看,方法本质是把误差从几何搬到渲染贡献的加权上,因此对点云整体偏差仍无解。
原文与来源
AI 依据论文正文生成,经人工审核;数字与结论以原文为准。
- 感谢你赐予我前进的力量
-
 微信
 支付宝