下一概念建模(NCM):从粗到细的并行文本生成
Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation
用多尺度残差VQ-VAE把文本拆成由粗到细的离散码层级,再让Transformer逐层并行生成整层码,从而以更少串行步数和更低单步成本完成高质量文本生成。
问题与背景
扩散语言模型(DLM,通过多轮去噪并行生成多个位置的非自回归语言模型)被视为替代逐词生成的路线,但论文指出其三个实际瓶颈:仍要很多采样步,减少步数会明显掉质量;每一步都要处理全序列,且双向注意力难以直接复用自回归的KV缓存;训练常需多轮遍历数据。已有的少步采样与蒸馏方法又增加训练阶段并损失多样性。
NCM 的出发点是改写「表示」和「生成顺序」:文本不再按词元逐个生成,而是先生成少量粗粒度码,再逐层补细节。
核心思路
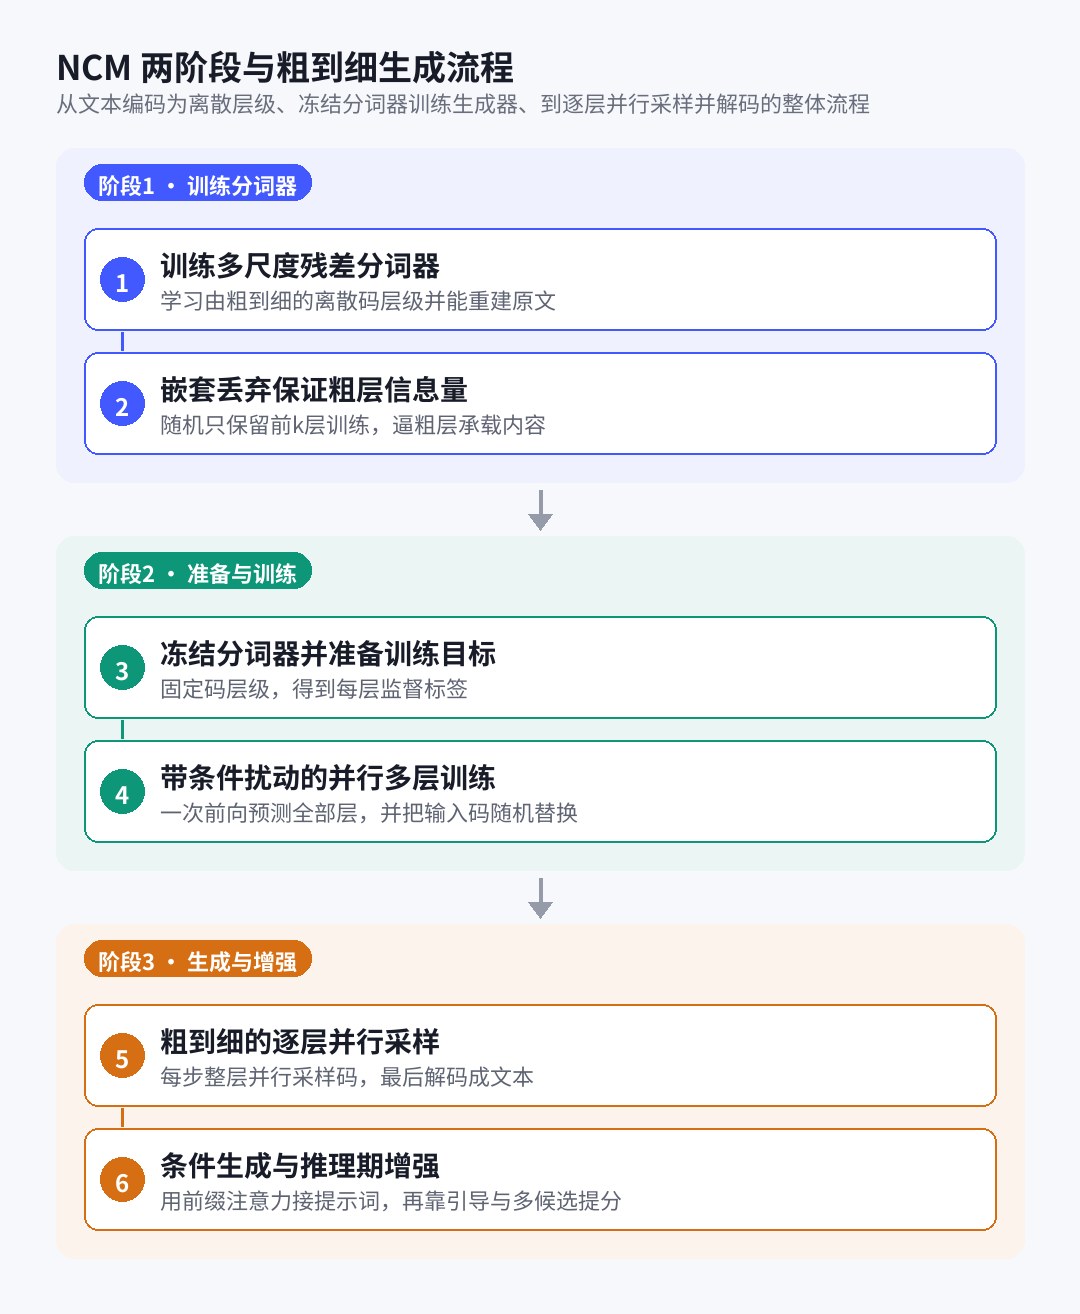
NCM 分两阶段。第一阶段训练一个多尺度残差VQ-VAE(向量量化变分自编码器:把连续隐向量映射到码本条目,并把每层量化误差留给下一层修正),把一条文本编码成K层离散码,层越粗码数越少、越细码数越多,最细层长度等于词元长度L。第二阶段冻结该分词器,训练一个共享Transformer按粗到细逐层生成:第k层以先前各层累积重建为条件,一次前向并行预测该层全部码。
这样串行步数只有K步且K远小于L,早期层只处理很短的码序列,单步成本也低;最后把累积重建交给分词器解码器还原成词元。
方法如何工作
训练多尺度残差分词器
编码器把文本映射为L个隐向量;第k层先把上一层残余误差下采样到 ℓ_k 个向量,再在码本 𝒱_k 中找最近邻得到该层码 r_k,经重建算子 R_k 映射回长度L并与累积重建相加,得到新的累积重建与残余。码数满足 ℓ_1<…<ℓ_K=L,因此粗层短、细层长。
嵌套丢弃保证粗层信息量
训练时随机采样截断层k,只用前k层重建并计算损失,使早期层必须独立携带可读信息,而非依赖细层兜底。分词器损失由截断处重建交叉熵、承诺损失与量化损失组成,离散量化梯度用直通估计器回传。
冻结分词器并准备训练目标
分词器训练完成后冻结,用其为每条文本编码出目标码 r_1:K。生成器只学习在这些码上的分布,表示学习与生成目标解耦,这也是作者列出的后续改进方向之一。
带条件扰动的并行多层训练
训练时把一部分条件码替换为同层码本中的随机码(保持标签为真码),模拟推理时自身生成错误逐层累积的情形;随后在一次前向中对所有K层计算加权交叉熵,权重 w_k 与 ℓ_k^{-α} 成正比,α=0 时按码位等权,等价于附录中ELBO的生成项。每个层块只关注自身输入块(块对角注意力),因为输入已经是先前层的累积重建。
粗到细的逐层并行采样
生成从空的累积重建开始:每步把上一步累积重建缩放到 ℓ_k 个位置并投影到隐宽,一次前向得到该层全部码的分布并并行采样,加上 R_k 的贡献得到新累积重建。K步之后由分词器解码器把最终重建还原为各位置词元分布,按argmax取词元。
条件生成与推理期增强
条件生成采用前缀-LM注意力:提示位置互相可见,目标块可见提示和自身,提示不可见目标。推理时可用分类器无关引导(同时算条件与无条件logits再组合;论文计两步函数评估),也可在相同预算内多采候选,用最小贝叶斯风险(MBR,选择与其余候选平均相似度最高者)解码。
一个例子(帮助理解,非原文实验)
(以下为解释性示例,非原文实验)设目标长度为 L=128,层级 K=12,最粗层只有1个码、最细层128个码。第一步,模型只有空条件,一次前向输出第1层那1个码,比如取到码本第 317 号条目;该条目经 R_1 展开成一条覆盖整句的粗略向量,内容大致相当于「一个关于寒冷夜里找温暖的故事」。
第二步,把这个粗向量缩放到第2层的码数(如2个位置),一次前向并行采到两个码,它们补上「女孩」与「外套会动」这类骨架信息。依此类推,较细层一次要采几十上百个码,逐层补足人名、动作与措辞。到第12层得到128个码的累积重建,解码器同时给出128个位置的词元分布并argmax成文。若第一步采到的码恰好偏差,条件扰动训练让模型在后续层有纠正机会——这正是论文所说粗层定大方向、细层填空并修正。
证据与实验
- 分词器质量:在OWT、LM1B、TinyStories、XSum、WMT14与Sudoku上报告精确重建率99.99%、99.86%、99.98%、99.79%、98.79%与100%,码本平均利用率62%至90%,Sudoku要求精确恢复故达100%。
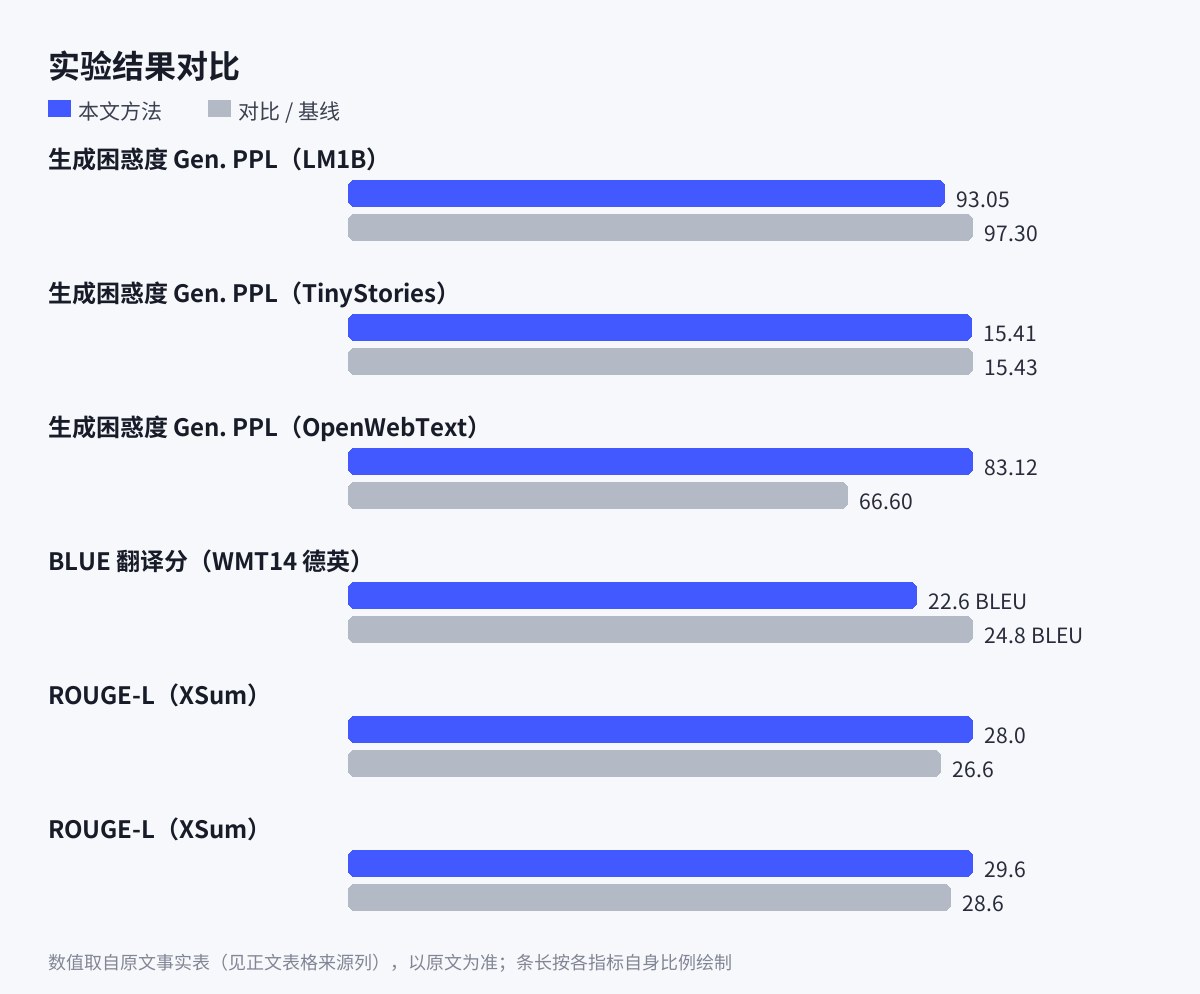
- 无条件生成:以GPT-2-large为参考模型算生成困惑度(Gen. PPL)并同时报告平均单样本一元熵。NCM在TinyStories用12步函数评估(NFE)得15.41、LM1B用12步得93.05、OpenWebText用32步得83.12,熵接近数据。
- 条件生成:WMT14德英无引导时NCM BLEU 22.6、仅11步,低于E2D2的24.8(64步);XSum无引导ROUGE-L 28.0、8步,优于AURORA-LM的26.6(128步);加MBR后BLEU 25.2、ROUGE-L 29.6。
- 推理任务:Sudoku完全解出的棋盘比例,简单/中等/困难为99.5/96.5/86.1,仅12次函数评估,高于FMLM+的97.7/92.8/81.3(16次)。
- 效率与训练预算:LM1B上函数评估比DUO少11倍、实际耗时快21倍;XSum比AURORA-LM快31倍;LM1B分词器加生成器共约13.36B词元位置,约为基线66B的4.9分之一。
- 扩展性:LM1B上97M、317M、725M参数生成器在固定训练词元预算下随规模提升生成困惑度并保持熵;XSum用MBR在相同采样时间预算下超过扩散基线。
| 指标 | 本文 | 对比/基线 | 数据集 | 条件 | 单位 | 来源 |
|---|---|---|---|---|---|---|
| 生成困惑度 Gen. PPL | 93.05 | 97.30 | LM1B | NCM 12步 vs DUO 128步,GPT-2-large参考 | — | §E.2 Unconditional Generation「Ours NCM 12 15.41 3.98 12 93.05 4.31 32 」 |
| 生成困惑度 Gen. PPL | 15.41 | 15.43 | TinyStories | NCM 12步 vs FMLM+ 128步 | — | §E.2 Unconditional Generation「FMLM+ 128 15.43 3.90 – – – 128 66.60 5.2」 |
| 生成困惑度 Gen. PPL | 83.12 | 66.60 | OpenWebText | NCM 32步 vs FMLM+ 128步 | — | §E.2 Unconditional Generation「FMLM+ 128 15.43 3.90 – – – 128 66.60 5.2」 |
| BLUE 翻译分 | 22.6 | 24.8 | WMT14 德英 | 无引导,NCM 11步 vs E2D2 64步 | BLEU | §4.3 Conditional Generation「Ours NCM 120M 22.6 11 88M 35.0 12.8 28.0」 |
| ROUGE-L | 28.0 | 26.6 | XSum | 无引导,NCM 8步 vs AURORA-LM 128步 | — | §4.3 Conditional Generation「NCM 120M 22.6 11 88M 35.0 12.8 28.0 8」 |
| ROUGE-L | 29.6 | 28.6 | XSum | NCM+MBR 128步 vs AURORA-LM 有引导 184步 | — | §4.3 Conditional Generation「Ours NCM + MBR 120M 25.2 132 88M 37.3 14」 |
| Sudoku 困难级完全解出率 | 86.1 | 81.3 | Sudoku | 30个提示数,NCM 12步 vs FMLM+ 16步 | % | §4.4 Reasoning「Ours NCM 25M 12 99.5 96.5 86.1」 |
各行数值来自标注章节的原句,以原文为准。
适用场景与局限
适合推理成本主导、且允许少量串行步的场景:无条件长文本生成、摘要(XSum)与翻译(WMT14)等条件生成、以及需要全局规划而非从左到右一次性定死的约束推理任务(论文以Sudoku为例)。尤其适合希望在相同采样时间预算内多采候选再用MBR挑选的服务端部署:用省下的时间换质量。
方法依赖为每个数据集单独训练并冻结的多尺度VQ-VAE分词器,对需要严格逐字复现的任务要关注分词器精确重建率(论文中Sudoku为100%,WMT14为98.79%)。由于生成路径固定为K层、层数不随输入变化,简单输入也要走完整个层级,不适合追求极短续写极致延迟的场景。
- 层级深度K与每层码数 ℓ_k 固定,即便很短续写也要走完整层级;作者建议改为依赖输入的自适应调度。
- 依赖单独训练的VQ-VAE分词器,表示学习与生成目标解耦;作者提出端到端训练可能带来收益。
- 主实验生成器多为约1亿参数,规模研究仅LM1B上到725M;更大数据与模型规模尚未验证。
- 生成总体流畅,但在粗层到细层的过渡处偶有瑕疵。
- 按本次解读:WMT14无引导BLEU仍低于E2D2(22.6对24.8),翻译并非全面领先;OpenWebText上的Gen. PPL(83.12)也高于FMLM+的66.60,只是后者熵偏低、部分反映多样性下降。(解读者观点)
- 按本次解读:条件扰动训练使用随机码替换,与推理时模型自身错误的分布并不一致,作者也指出基于实际错误构造扰动留待未来工作。(解读者观点)
结论与来源
论文提出两阶段NCM:先用多尺度残差VQ-VAE学习文本的离散层级,再训练Transformer按粗到细逐层并行生成。作者报告在三套无条件数据集上以约4至11倍更少的函数评估取得竞争性或更好的生成困惑度并保持接近数据的熵,生成速度快10至21倍;条件生成XSum上取得最佳ROUGE且快31倍;Sudoku各难度均优于自回归与扩散基线且函数评估更少;训练词元预算约省4至5倍。
解读上,其价值主要在于把「并行」从同一全序列上反复去噪,改为在短码层级上逐层推进,但翻译质量仍非全面领先,且需要额外训练分词器。
原文与来源
AI 依据论文正文生成,经人工审核;数字与结论以原文为准。
- 感谢你赐予我前进的力量
-
 微信
 支付宝