BlenderWorld:以真实世界参考为输入的3D创作视觉智能体评测基准
BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
论文提出 BlenderWorld,用223个贴近真实生产需求的 Blender 3D 创作任务与「多视角渲染+分项二元评分+结构检查」的统一评测协议,检验视觉智能体能否从文本、图像、视频参考中真正构建出结构可靠的3D作品。
问题与背景
基于多模态大模型(MLLM,能同时处理文字与图像的模型)的视觉智能体已在网页、海报、版面等二维设计任务上展现出能力,并开始向三维建模延伸。3D 建模对智能体是很有价值的试验场:它需要长程工具协作、跨数十轮交互,覆盖从日常小物件到整片街区的尺度,还要求空间推理与主动视觉核验。但用真实3D任务评测智能体存在三个难点。
其一是环境:既要能创作、编辑,又要能检查,同时具备三者的环境并不多,作者因此选用开源平台 Blender,它可通过 Python 脚本与 MCP(Model Context Protocol,模型上下文协议)接口操控。其二是任务覆盖:真实需求从照片重建到开放式设计简报差异极大,而现有 Blender 类基准多聚焦单一物体、少量相机或场景编辑任务,或只针对预设几何目标。
其三是结果评估:真实需求往往没有标准3D资产,开放式简报又允许多种合理解,只看一张渲染图不足以判断视觉外观与底层结构。
核心思路
BlenderWorld 的核心思路是:把评测建成「真实生产简报 + 可编辑交付物 + 证据可追溯的评分」三段式。任务侧,作者沿类别体系与应用场景两条轴组织覆盖,让参考图承担重建、修改或参考式设计三种角色,并把需求落到具体应用语境(如施工报告强调结构关系,产品发布强调可见性与外观),部分任务附带 Markdown、YAML 或 JSON 规格文件约束尺寸、材质、相机等。
评分侧不设唯一标准答案,而是把简报要求拆成大量任务专属的二元判据,并为每条判据指定证据来源:能靠看渲染图判断的交给视觉模型判官,涉及内部结构、精确尺寸、文件属性等无法从图上看出的,交给能直接检查 .blend 工程的智能体判官。两条证据路径与八项整体视觉质量打分融合成一个任务分。这样既容纳多种合法实现,又能绕开「只把画面做得好看」的视觉捷径。
方法如何工作
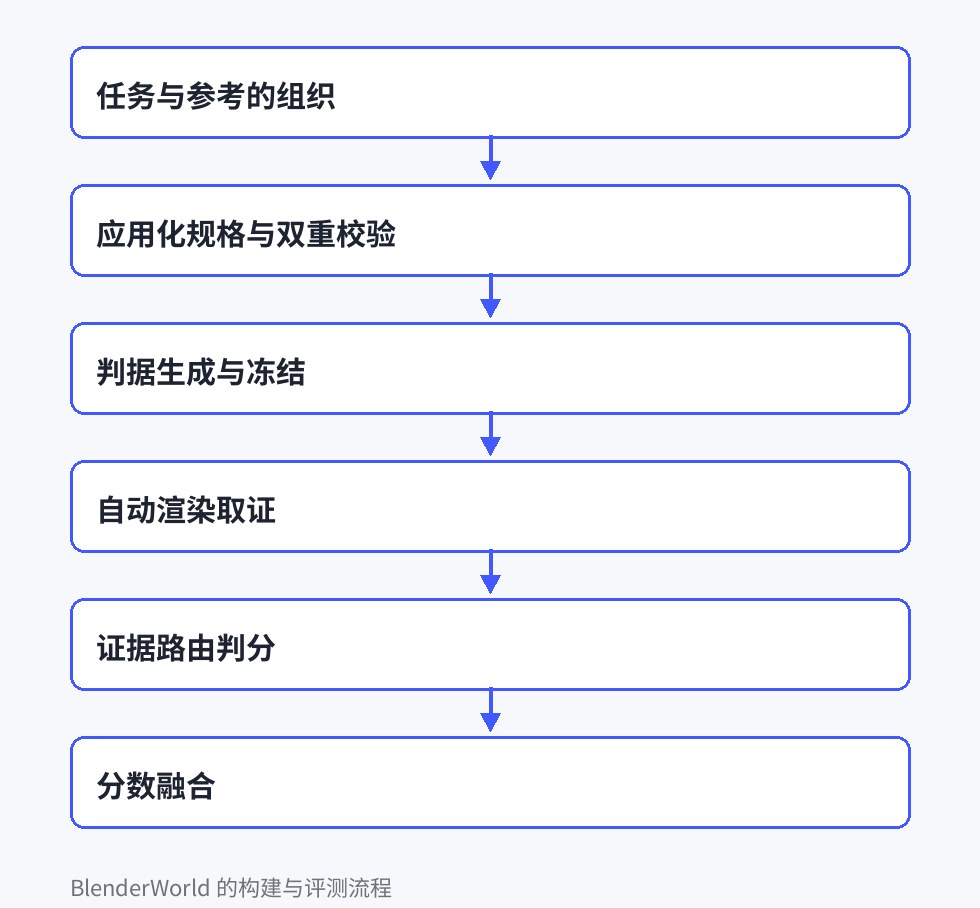
任务与参考的组织
作者沿类别体系与应用场景两维度设计任务,并变化生产需求(目标领域、场景复杂度、用户专业度、请求长度)与参考使用方式。参考图先由模型筛选质量与结构复杂度,再赋予三种角色之一:重建保留主体形状与空间关系,修改在保留指定结构的前提下改动,参考式设计借其形态、风格或布局做新设计。任务最终写为自然语言简报,明确生产目标与关键要求。
应用化规格与双重校验
每条规格被放进一个现实应用场景中表述,必要时附带包含尺寸、材质清单、相机设置或资产预算的附件,并在请求中显式引用。随后做双轨校验:结构检查确认元数据相容、图片与附件可访问、结构化文件可解析、简报同时要求渲染输出与可编辑工程;语义检查由与生成器不同的模型独立比对简报、改写请求、参考图与附件,核查图文对齐、约束一致性、关键要求保留与可行性,不合格者退回重写。
判据生成与冻结
生成器从通过的简报中抽取要求,转为带来源链接的二元判据,每条归入13个类别之一、赋予重要度权重(主要/次要/细节为 3/2/1),并指定证据类型为渲染或场景摘要。草稿先用试探性评测暴露歧义,再由至少两个独立评审模型用具体反例核查覆盖度、来源支撑与可评判性,编辑处理异议,凡涉及语义改动须再次评审,最后冻结。
自动渲染取证
评价阶段先归档智能体交付的 .blend 工程、导出媒体与附件。自动智能体渲染(AaR)依据任务、判据与参考,自行选择八个互补视角,以 1024×1024、64 采样、Cycles 渲染。渲染者可调整相机与取景,但不得修补提交内容中的缺陷;无效视角最多重渲两次,若无法产出新渲染则该次评测记为失败,原始导出媒体仍作为补充证据。
证据路由判分
每条判据按所需证据分流:场景摘要类交智能体判官,通过 Blender 工具检查内部状态并记录证据,必要时参考图像;渲染类交视觉模型判官,输入自动渲染视角、原始导出媒体与从视频中抽取的有序帧,冲突时以原始导出媒体为准。另有一轮盲评生成不含提示语的提交与参考描述作为辅助依据。无证据支撑的判据主张记零分。视觉判官还对八项维度各给 1–10 分并附理由。
分数融合
任务分由两部分构成:分项得分按权重计算加权通过率为 ,维度得分为 ,两者按 融合,取 。
最终报告223个任务的均分,并分别给出纯文本与多模态子集均分;失败评测记零且留在分母中。
一个例子(帮助理解,非原文实验)
设想一条「按参考照片重建一个带四腿和脚轮的柜子」的简报,附件写明木腿长150毫米。智能体在容器里写 Python 操作 Blender,渲染后自检,看到画面比例正常便提交。评测时,自动渲染器从八个角度看,视觉判官据此判外观类判据:颜色、布局、材质观感大体通过;而「木腿实际长度为150毫米」属于场景摘要类,交智能体判官直接打开工程量取内部尺寸,结果发现木材只有102毫米、其余为脚轮,该条判零。
作者在附录中报告过类似案例:某系统把含脚轮的总高当作木腿长度来自检,自检「通过」,但冻结的场景检查仍判该条失败。最终该任务的融合分由分项得分与八项视觉质量分各半决定,不会因为一张好看的正视图而掩盖结构错误。需要说明:以上为帮助理解流程的示例,其中场景与数字取自作者的缺陷分析案例,并非原文的实验设置或结果表。
证据与实验
- 评测设置:13个智能体在同样的223个任务上各跑一次(其中78个纯文本、145个多模态),使用最高可用推理强度,运行于隔离 Linux 容器(每任务一块 NVIDIA GPU)并预装 Blender LTS。生成与评测容器严格分离,评分规则在生成阶段对智能体不可见以防止「针对判据作弊」。自动渲染、判据判定与维度判定统一采用 GPT-5.6-terra。
- 主结果:GPT-6-Astra 取得最高总分79.9,其后为 Opus-5(73.0)与 GPT-5.6-Sol(67.7)。其领先在多模态任务上更明显(80.7 对 72.1),纯文本上为78.6 对74.8;分项与维度两项均居首。但完美通过率仍有限:GPT-6-Astra 仅42.2%的任务满足全部判据,Opus-5 为25.6%,其余智能体最高15.7%。
- 过程统计:不同智能体的规划与迭代风格差异明显。GPT-5.6-Sol 每任务平均39.9K输出 token、44.0次工具调用,而 DeepSeek-V4.1-Flash 为209K token、168次调用。GPT-6-Astra 以更少 token 与调用取得最高分;Opus-5 的 Blender 执行次数与看图次数约为 GPT-6-Astra 的两倍(45.5 对23.3、27.1 对15.0)。
- 分析与失败模式:类别层面 GPT-6-Astra 在九类中的八类领先,程序化/游戏资产(86.8)与产品制造(83.9)最高;渲染与仿真一类被 Opus-5 反超(74.5 对71.1)。定性审计归纳出四类反复出现的失败:缺失动态交互、视角不一致(提交视角可见、侧视时消失)、细粒度几何畸变、接触约束违反(人物悬空)。
- 判官对齐与稳健性:在147组人类多数偏好样本上,GPT-5.6-terra 的整体分与人一致率82.99%,平均分差小于10的子集降至68.57%;其整体分与人类偏好的 Pearson 相关为0.714、Spearman 为0.744、Kendall 为0.607。融合权重在0到1间变动时,除 Grok-4.6 与 Opus-4.8 互换第七名外,总体排名不变。
- 补充观察:分项分与维度分在2,899件产物上的 Spearman 相关为0.630,说明「照做要求」与「好看」大体同向但并不重合。阈值分析显示 GPT-6-Astra 有143个任务达到90%权重覆盖,但仅94个任务全通过;完美通过的任务集合在各系统间并不完全嵌套,最弱系统也有1个任务为 GPT-6-Astra 所未通过。
| 指标 | 本文 | 对比/基线 | 数据集 | 条件 | 单位 | 来源 |
|---|---|---|---|---|---|---|
| 融合总分(223任务均分) | 79.9 | 73.0 | BlenderWorld 全部223任务 | GPT-6-Astra 对 Opus-5,各任务单次运行,$\lambda=0.5$ | 分(0–100) | §5.2 Main Results「It achieves an overall Score of 79.9, ah」 |
| 纯文本任务均分 | 78.6 | 74.8 | BlenderWorld 78个纯文本任务 | GPT-6-Astra 对 Opus-5 | 分(0–100) | §5.2 Main Results「Its lead over Opus-5 is larger on multim」 |
| 多模态任务均分 | 80.7 | 72.1 | BlenderWorld 145个多模态任务 | GPT-6-Astra 对 Opus-5 | 分(0–100) | §5.2 Main Results「(80.7 vs. 72.1)」 |
| 完美通过率(全部判据满足的任务占比) | 42.2 | 25.6 | BlenderWorld 全部223任务 | GPT-6-Astra 对 Opus-5 | 百分比(原文为比例 42.2% 与 25.6%) | §5.2 Main Results「GPT-6-Astra achieves a Perfect rate of 4」 |
| 每任务平均输出 token | 44.0 | 209 | BlenderWorld 全部223任务 | GPT-5.6-Sol 对 DeepSeek-V4.1-Flash | 千 token(K)(原文单位为 K,44.0K 与 209K) | §5.2 Main Results「GPT-5.6-Sol averages 39.9K output tokens」 |
| 每任务平均工具调用次数 | 44.0 | 168 | BlenderWorld 全部223任务 | GPT-5.6-Sol 对 DeepSeek-V4.1-Flash | 次 | §5.2 Main Results「compared with 209K tokens and 168 calls 」 |
| 与人类多数偏好的一致率(整体分,147组) | 82.99 | 77.55 | 150组同输入产物对,剔除3组各得一票后为147组 | GPT-5.6-terra 对 Gemini-3.8-Flash 判官 | 百分比 | §E.1 Detailed Analysis of Judge Model「82.99% for GPT-5.6-terra, 77.55% for Gem」 |
| 小分差子集(平均分差<10)一致率 | 68.57 | 55.71 | 70组小分差样本 | GPT-5.6-terra 对 DeepSeek-V4.1-Flash 判官 | 百分比 | §E.1 Detailed Analysis of Judge Model「the agreement for these three models dec」 |
| 分项分与维度分的相关性 | 0.630 | — | 2,899件产物 | Spearman 相关系数 | 无量纲 | §E.6 Sensitivity to the Fusion Weight「the Spearman correlation coefficient acr」 |
| 渲染与仿真类别得分 | 71.1 | 74.5 | 渲染与仿真类别任务子集 | GPT-6-Astra 对 Opus-5(该类别 GPT-6-Astra 唯一落后) | 分(0–100) | §E.7 Task-Category Profiles for All Systems「Rendering & Simulation is the exception,」 |
各行数值来自标注章节的原句,以原文为准;标(换算)的行在单位列注明原文表示。
适用场景与局限
该基准适合用来比较和诊断「能操作软件的视觉智能体」在三维内容生产上的能力,尤其适合三类研究:一是评测不同模型与智能体外壳(harness,即工具集与运行框架)组合在长程工具使用上的表现;二是研究如何把被动看图反馈转化为有效的结构修正;三是检验评测方法本身,例如视觉判官与程序化检查如何互补、二元判据与连续质量分如何取舍。
任务形态贴近实际生产:施工报告、产品发布、电商视觉、教学插图、科学可视化、游戏资产等,因此对希望把智能体接入真实3D工作流的团队也有参考价值,可借其判据设计思路搭建内部验收清单。协议中「生成与评测容器分离、判据对生成方不可见」的做法,对任何需要防止针对评分规则过拟合的评测都有借鉴意义。
需要强调的是,它评测的是「在 Blender 中以脚本和 MCP 工具完成可编辑交付物」这一设定,并非通用3D生成质量榜;跨应用(如 Maya、3ds Max)与图形界面操作(CUA)被作者列为未来工作。
- 任务规模为223条、每个模型每任务只运行一次,作者在结果中报告的是单次运行表现,排名稳定性未通过重复运行估计(未来工作提到将做重复运行以估计方差)。(解读者观点)
- 评分依赖模型判官:在小分差子集上,最佳判官与人类多数偏好的一致率也只有68.57%,说明对质量接近的产物,自动评分与人判断仍有明显差距。
- 预览阶段的判据打磨使用了 GPT-5.6-Sol,且评审模型包含被测体系相关的模型,虽然采取独立评审与冻结流程,仍可能存在与被测模型风格相关的偏置;这是解读层面的关切,原文未做该方向的消融。(解读者观点)
- 当前判据以二元通过为主,对有机形体等二元区分度有限的题材判别力不足,作者计划引入分级评估与专家校准。
- 对精确尺寸、公差、机构行为等工程性要求的检查仍以判据与场景检查为主,作者计划补充参考解、几何指标(如体素 IoU)与可交互的参数化检查。
- 评测绑定 Blender 4.2.10 LTS 与特定智能体外壳(Codex 或 Claude Code),工具可用性差异会影响得分,跨外壳与跨平台的公平比较尚待展开。
结论与来源
作者结论是:BlenderWorld 提供了面向真实3D重建、修改与设计的智能体基准,223条任务横跨9大类16个应用场景,要求可编辑工程与任务专属交付物;评测把任务条件下的多视角渲染、场景检查、2,651条二元判据与视觉质量打分结合,同时衡量要求满足度与成品质量。
13个智能体中 GPT-6-Astra 以79.9分居首,但仅42.2%的任务通过全部判据;定性分析揭示交互不完整、跨视角不一致、几何畸变与接触违反等问题,说明把任务要求与视觉参考转化为连贯的3D结构与行为仍是难点。从解读角度看,这项工作更重要的贡献可能不在名次,而在评测设计:把「证据从哪来」显式写进每条判据,并用程序化检查堵住二维视觉捷径,才让「看起来对」与「结构上对」被区分开。
作者也明确把交互式与参数化评测、更高复杂度任务、专家对齐的细粒度判据、多 DCC 生态与更广的模型/外壳覆盖列为后续方向,因此上述排名应视为该设定与协议下的阶段性快照。
原文与来源
AI 依据论文正文生成,经人工审核;数字与结论以原文为准。
- 感谢你赐予我前进的力量
-
 微信
 支付宝