OpenMobile-2:用可扩展环境与应用原生工具构建通用移动智能体
OpenMobile-2: Building Versatile Mobile Agents with Scalable Environments and App-Native Tools
该工作面向开放社区缺乏可扩展移动训练环境与数据的困境,构建了涵盖110余个应用的可控模拟与仿真环境、近12K轨迹与2K余可验证强化学习任务,并提出GUI动作与应用原生工具交替使用的混合交互范式。
问题与背景
移动智能体(mobile agent,指通过点击、滑动、输入等动作操作手机界面的视觉语言模型智能体)的能力高度依赖大规模交互经验,但高质量轨迹数据大多掌握在闭源机构手中,开放社区的训练资源有限,开放模型明显落后。要低成本扩展交互经验,需要一个多样且可控的移动实验场。现有开放工作多依赖Android模拟器中的少量开源应用:交互真实,但第三方应用难以可靠重置,完整Android栈的并行化成本高。
近期的模拟应用环境可以高效重置与并行,但应用数量少、功能浅,且缺乏可扩展的构建方法。商业应用上的长程跨应用工作流训练与评测环境因此尤其缺失。[2][4]
核心思路
论文把“环境规模化”作为核心抓手:在MobileGym模拟框架上重建35个高保真商业风格应用(合计63个可安装客户端),配合新配置的Android模拟器应用形成覆盖110余个应用的训练场;由于应用状态完全可序列化,可做确定性重置与程序化验证。在此基础上用教师模型合成并过滤轨迹与可验证任务,得到OpenMobile-Data-v2,用于监督微调与强化学习。
第二条主线是交互通道的扩展:让应用把部分功能以“应用原生工具”(app-native tools,即应用自身暴露的结构化查询或写入接口)的形式与GUI并列提供,工具与GUI操作同一份应用状态、共享同一终局判定。这样同一任务既可用纯GUI完成,也可用GUI与工具交替完成,从而在同一任务集上受控比较两种通道。[2][7][8]
方法如何工作
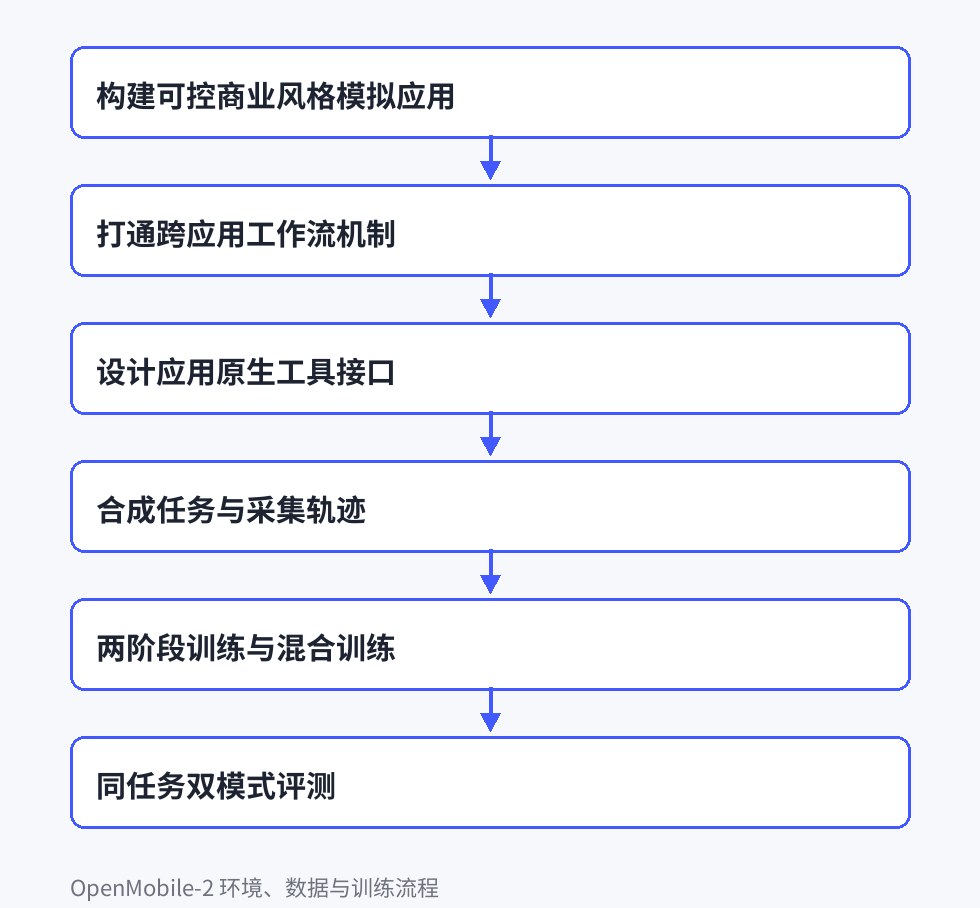
构建可控商业风格模拟应用
以MobileGym运行时为基础,先写数据模式与交互图规格,再渲染界面。每个应用维护订单、预算、行程等持久业务状态,观测只有原始屏幕像素,无无障碍树,智能体不能直接读取业务状态。设备状态可完全序列化,支持确定性重置与轻量并行实例化。交付前做覆盖检查(声明的交互是否都有实现)与核心流程回放检查。[4][5][21]
打通跨应用工作流机制
所有应用运行在共享、可重置的设备上,通过剪贴板传递、应用间分享、支付跳转、媒体选择等机制让信息与动作跨应用边界流动,从而支持真实的多应用工作流而非孤立单应用任务。[6]
设计应用原生工具接口
每个工具是对应用自身业务对象的结构化查询或写入,并与对应GUI交互语义等价;工具调用与GUI操作修改同一持久状态、由同一终局条件判定。工具仅在该应用位于前台时可用,因此策略每步在GUI动作与可用工具间选择。共在50余个应用上实现300余个工具,任务全部仍可纯GUI完成。[7][17]
合成任务与采集轨迹
为每个应用构建状态—动作转移图,形成全局视图与局部视图;在模拟器侧探索界面并合并相似截图,在MobileGym++侧直接由后端规格导出。以Gemini-3.1-Pro-Preview依据视图生成可执行用户指令并做质量与多样性过滤,再作为教师智能体执行任务产生轨迹,仅保留通过验证器的成功轨迹,并逐步过滤无意义循环与不改变状态的动作。[10]
两阶段训练与混合训练
从基座模型做两次5轮监督微调:GUI-only只用GUI轨迹,Hybrid用完整混合数据(含1,774条GUI与工具交替的模拟器轨迹)。强化学习从Hybrid检查点初始化,在512个可执行任务上采用组相对优势与DAPO目标,奖励由验证器、工具使用加成、长度因子与格式/虚假完成惩罚相乘构成。[12][17][18]
同任务双模式评测
提出MobileGym++ Bench,215个任务覆盖单应用到四应用,每个任务绑定初始状态与对业务状态前后差异的程序化检查器,不检查轨迹或截图、不用模型裁判。同一任务集同时评测纯GUI与混合模式,主指标为成功率。[8]
一个例子(帮助理解,非原文实验)
以下为解释性示例,并非原文实验。设想一个任务:“在小红书搜索‘旅行’,把前十条结果里点赞最高的两篇帖子标题写进系统备忘录”。纯GUI模式下,智能体要自己点搜索框、输入关键词、滑动浏览、比较点赞数、长按复制标题、切到备忘录粘贴,步骤多且易错。
混合模式下,应用暴露了搜索与读取摘要的工具:智能体可先调用类似 search_items 的工具拿到候选列表与点赞数,再用工具取回标题文本,最后仍需切到备忘录用GUI粘贴并提交。注意工具只覆盖部分功能,例如结算类工具只打开确认页而不生成订单与支付,收尾仍要在GUI完成。
这正体现论文的设计:工具与GUI共享同一应用状态、同一成功判定,因此两种通道可在同一任务上受控比较;而原文发现,未经混合训练时模型很少主动调用工具,收益有限,混合训练后工具调用才显著变得更有效。[7][13][29][30]
证据与实验
- 主结果:27B模型在AndroidWorld达79.9、MobileWorld达50.4,SPA-Bench(真实设备)从基座31.9提升到59.6;9B模型从基座54.3提升到74.0(AndroidWorld),两个规模在MobileWorld与MobileGym++上也一致提升。[13]
- 强化学习效果:MobileGym成功率从35.9升至38.3(9B)、48.4升至51.2(27B),27B的SPA-Bench从57.4升至59.6;其他基准增益有限,作者认为RL收益依赖训练环境与评测场景的对齐。[13]
- 工具通道:MobileGym++ Bench混合评测中,混合SFT相对GUI-only SFT在9B为41.9到44.7、27B为57.7到65.6,纯GUI成功率基本持平。MobileWorld MCP上混合SFT为27.5和45.0,对照12.5和35.0。[13]
- 环境覆盖分析:固定2K模拟器轨迹预算,训练应用数从15增至53,未见应用Pass@1从60.7升至67.5,分布内Pass@1从73.7小幅降至71.4。[14]
- 工具使用分析:混合SFT后工具调用覆盖任务数升至113与128(共215),涉及110与115个不同工具,工具带来增益升至5.6与10.3分,轨迹分别缩短4.8与5.8步。[14]
| 指标 | 本文 | 对比/基线 | 数据集 | 条件 | 单位 | 来源 |
|---|---|---|---|---|---|---|
| AndroidWorld Pass@1 | 74.0 | 54.3 | AndroidWorld(116任务,20个真实应用) | 9B模型,基座Qwen3.5-9B,混合SFT+RL | 成功率% | §5.2 Main results「the 9B model gains 19.7 points on Androi」 |
| AndroidWorld Pass@1 | 79.9 | 67.1 | AndroidWorld | 27B模型,基座Qwen3.6-27B,混合SFT+RL | 成功率% | §5.2 Main results「the 27B model gains 12.8 points (67.1 to」 |
| MobileGym 成功率 | 51.2 | 48.4 | MobileGym | 27B,混合SFT对比混合SFT+RL | 成功率% | §5.2 Main results「raising MobileGym success rate from 35.9」 |
| MobileGym++ Bench 混合模式成功率 | 65.6 | 57.7 | MobileGym++ Bench(215任务) | 27B,混合SFT对比GUI-only SFT,混合评测 | 成功率% | §5.2 Main results「27B: 57.7 to 65.6」 |
| MobileWorld MCP 通过率 | 45.0 | 35.0 | MobileWorld(MCP模式) | 27B,混合SFT对比GUI-only SFT,工具未见 | Pass@1 % | §5.2 Main results「hybrid SFT achieves 27.5 and 45.0 versus」 |
| 未见应用 Pass@1 | 67.5 | 60.7 | AndroidWorld(留出应用) | 固定2K模拟器轨迹,应用覆盖15到53 | 成功率% | §5.3 Analysis「Pass@1 increasing from 60.7 to 67.5」 |
| 工具调用任务覆盖数 | 128 | 102 | MobileGym++ Bench(215任务) | 27B,混合SFT后对比基座 | 任务数 | §5.3 Analysis「tool calls appear in 113 and 128 tasks」 |
各行数值来自标注章节的原句,以原文为准。
适用场景与局限
适合以下场景:一是需要在商业风格应用上做长程、跨应用移动智能体训练与评测的研究,尤其是关注订单、预算、行程等业务状态写入的任务;二是希望在同一任务集上受控比较纯GUI与GUI加工具混合交互的研究者,可借助共享状态与共享判定设计对照实验;三是需要可确定性重置、可并行化、可程序化验证的强化学习实验平台;四是关心模拟环境训练向真实设备迁移的团队,论文在SPA-Bench上报告了迁移结果。
数据侧可直接使用近12K示范轨迹与2K余可执行RL任务,覆盖模拟器与模拟客户端两类来源。[2][9][13][14]
- 工具使用是探索性设置,工具由人为划定范围并在模拟应用内实现,与真实商业应用是否愿意暴露同类接口存在差距。(解读者观点)
- 作者指出强化学习只在训练对齐的环境上带来明显增益,其他基准提升有限,表明RL收益依赖训练与评测场景的对齐。
- 模拟客户端为高保真重建而非真实应用,登录摩擦、不可逆副作用等真实约束被规避,保真度与真实部署仍有差距。(解读者观点)
- 作者用嵌入相似度检查训练与评测目标的重叠,但仅报告相似度阈值统计,不能完全排除隐性泄漏。(解读者观点)
结论与来源
论文给出了一套开放的移动智能体训练栈:环境侧以MobileGym++与新增模拟器应用构成110余个应用的可控训练场,数据侧发布近12K示范轨迹与2K余带自动奖励的可执行RL任务,并训练出在AndroidWorld(79.9)与MobileWorld(50.4)上具竞争力的模型,在真实设备SPA-Bench上从31.9提升到59.6。
作者的核心发现是:单纯提供工具收益有限,混合训练才能显著放大工具价值,并提升交互效率;同时扩大应用覆盖可在固定数据预算下改善对未见应用的迁移。以上结论均来自作者报告。[1][13][14][15]
原文与来源
AI 依据论文正文生成,经人工审核;数字与结论以原文为准。
- 感谢你赐予我前进的力量
-
 微信
 支付宝