PaperBanana:为 AI 科学家自动化生成学术插图的智能体框架
PaperBanana: Automating Academic Illustration for AI Scientists
论文提出 PaperBanana,用检索参考图、内容与风格规划、生成和自评迭代的多智能体流程,把方法章节文本与图注自动转成接近发表水准的方法示意图和统计图。
问题与背景
自主 AI 科学家已能承担文献综述、想法生成与实验迭代等环节,但把研究发现转化为符合期刊规范的插图仍是耗时瓶颈。已有做法多用 TikZ、Python-PPTX 或 SVG 等代码方式程序化合成示意图,对结构化内容有效,却难以表现现代 AI 论文中常见的专门图标与自定义形状;图像生成模型虽指令跟随与画质进步明显,稳定产出学术级插图仍很困难。
论文同时指出缺少专门评测基准,因此构建了 PaperBananaBench。
核心思路
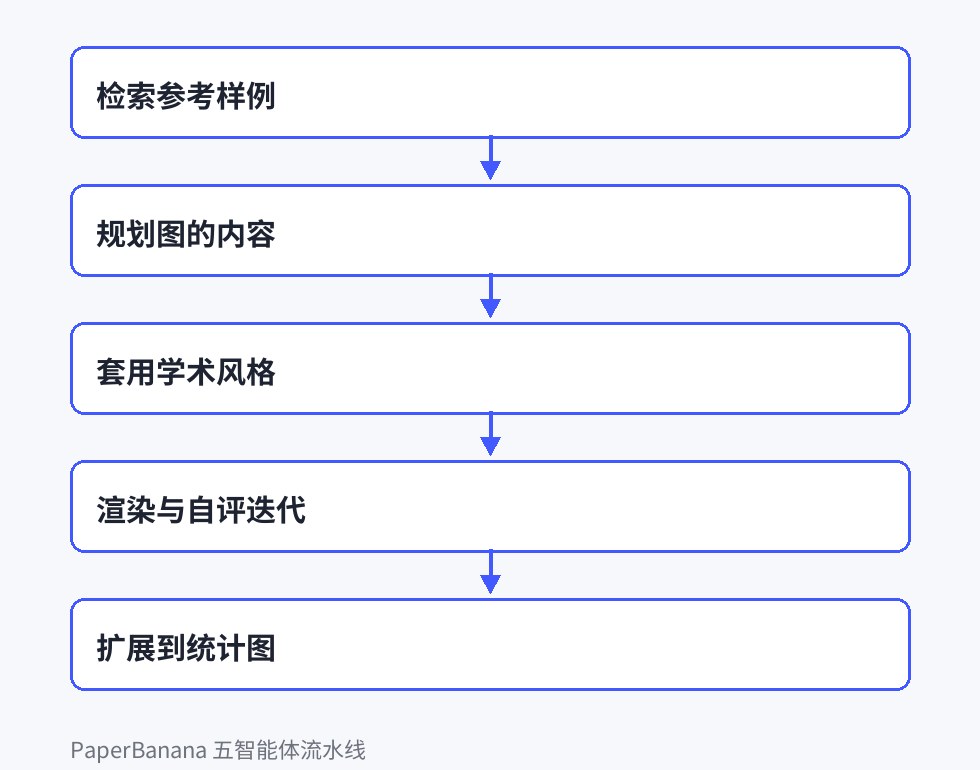
PaperBanana 把插图生成看成带参考样例的条件映射:给定方法描述与图注,先从参考集中检索结构相近的样例,再由规划智能体写出目标图的详细文字描述,由风格智能体按自动总结的学术审美指南改写描述,最后由可视化智能体渲染、评论智能体对照原文挑错并回写新描述,循环三轮。其关键判断是:参考样例主要提供结构与风格范式,而不必精确匹配内容;风格优化会牺牲部分忠实度,但可由评论环节补回。
统计图则把可视化换成生成可执行的 Matplotlib 代码,以保证数值精度。
方法如何工作
检索参考样例
检索智能体从固定参考集 中选出 N 个最相关样例 ,每个样例是(方法描述、图注、插图)三元组。它让视觉语言模型对候选元数据做生成式排序,先看研究方向(如智能体与推理)与图类型(如流水线、架构),并优先考虑视觉结构而非主题相似度。
规划图的内容
规划智能体以方法描述、图注和检索到的样例为输入,通过上下文学习把非结构化或结构化的原始内容转写为一段详尽的目标插图文字描述 ,即 ,为后续渲染提供内容骨架。
套用学术风格
风格智能体遍历整个参考集,自动总结出覆盖配色、形状与容器、线条与箭头、版式构图、字体与图标的美学指南 ,再把初稿描述润色为 ,使输出更贴近现代学术手稿的视觉规范。
渲染与自评迭代
可视化智能体用图像生成模型把描述渲染成图 ;评论智能体对照原始 检查事实错位、视觉瑕疵并提出修改,产出新描述 。循环 轮,取最终图。
扩展到统计图
面向统计图时,可视化智能体改为把描述转成可执行的 Python Matplotlib 代码 以保证数值精确,评论智能体同样评估渲染结果并回写描述,仍迭代三轮;论文也对比了直接用图像生成的做法。
一个例子(帮助理解,非原文实验)
(以下为帮助理解的示例,并非原文实验。)假设一篇论文描述了一个「检索—规划—生成」的三段式智能体流程,图注写「框架总览」。
检索环节先找到若干同属智能体类、且画成横向流水线的参考图;规划环节据此写出一段文字,说明三个模块各自输入输出、箭头方向与并列关系;风格环节把这段文字改写成「使用柔和配色、圆角矩形模块、统一线宽箭头」的施工说明;渲染得到初图后,评论环节对照方法描述发现「规划模块到生成模块的箭头被画反」,于是修改描述再渲染。三轮之后,文字细节更贴合原文,版式也更统一。
这个例子说明该框架并非一次成图,而是把「画什么」与「怎么画」分开,再靠评论环节纠偏。
证据与实验
- 在 PaperBananaBench 的 292 个测试样例上,以 Gemini-3-Pro 为视觉语言主干、Nano-Banana-Pro 为图像生成模型,PaperBanana 在忠实度、简洁度、可读性、美观度与总体分上均高于直接提示、十例少样本和 Paper2Any 三类基线。
- 相对直接提示 Nano-Banana-Pro,总体分提升 17.0%,其中简洁度提升最大(+37.2%),忠实度仅 +2.8%,论文也承认忠实度仍低于人类参考。
- 消融显示:去掉评论环节后忠实度明显下降(45.8 降至 30.7);加入风格智能体提升简洁度(+17.5%)与美观度(+4.7%)但压低忠实度(-8.5%);随机检索与语义检索效果相近,说明通用结构范式比精确内容匹配更关键。
- 50 例盲测中,三名人类评审对 PaperBanana 相对直接提示 Nano-Banana-Pro 的平均胜/平/负为 72.7%/20.7%/6.6%。
- 统计图任务在 240 个由 ChartMimic 改造的测试例上,相对直接使用 Gemini-3-Pro,总体提升 4.1%,并在简洁度、可读性、美观度上略超人类参考。
- 用自动总结的风格指南美化人类手绘图,292 例中美观度胜/平/负为 56.2%/6.8%/37.0%。
| 指标 | 本文 | 对比/基线 | 数据集 | 条件 | 单位 | 来源 |
|---|---|---|---|---|---|---|
| Overall | 60.2 | 43.2 | PaperBananaBench(292 例) | Nano-Banana-Pro 为图像模型,直接提示为基线 | 分(0-100) | §4.2 Evaluation Protocol「w/ Nano-Banana-Pro 45.8 80.7 51.4 72.1 6」 |
| Faithfulness | 45.8 | 43.0 | PaperBananaBench(292 例) | Nano-Banana-Pro,对比直接提示 | 分(0-100) | §4.2 Evaluation Protocol「Nano-Banana-Pro 43.0 43.5 38.5 65.5 43.2」 |
| Conciseness | 80.7 | 43.5 | PaperBananaBench(292 例) | Nano-Banana-Pro,对比直接提示 | 分(0-100) | §4.2 Evaluation Protocol「w/ Nano-Banana-Pro 45.8 80.7 51.4 72.1 6」 |
| Readability | 51.4 | 38.5 | PaperBananaBench(292 例) | Nano-Banana-Pro,对比直接提示 | 分(0-100) | §4.2 Evaluation Protocol「w/ Nano-Banana-Pro 45.8 80.7 51.4 72.1 6」 |
| Aesthetic | 72.1 | 65.5 | PaperBananaBench(292 例) | Nano-Banana-Pro,对比直接提示 | 分(0-100) | §4.2 Evaluation Protocol「w/ Nano-Banana-Pro 45.8 80.7 51.4 72.1 6」 |
| Overall(去掉评论环节) | 45.6 | 60.2 | PaperBananaBench(292 例) | 消融,完整配置为默认设置 | 分(0-100) | §5.4 Ablation Study「③ ✓ ✓ ✓ ✓ - 30.7 79.2 47.0 72.1 45.6」 |
各行数值来自标注章节的原句,以原文为准。
适用场景与局限
适合需要快速产出方法总览图的 AI 研究者:手头有成段方法描述与图注、但缺少设计资源或绘图工具经验时,可用该流程生成候选图再人工挑选。参考集驱动的方式也便于迁移到有固定社区规范的领域(论文提到 UI/UX、专利制图、工业示意图),因为不需要针对领域做昂贵微调。对含大量数值的统计图,代码路径比图像生成更稳妥;对稀疏、结构简单的图,图像生成观感更好。
论文建议实际使用时一次生成多张候选再人工挑选,并保留人工审核以防视觉幻觉。
- 输出是位图,难以像矢量图那样无限缩放与精确编辑;作者提出图像编辑模型、元素分割重建或操作矢量软件的图形界面智能体三条可能路径。
- 统一风格指南保证规范的同时压缩了风格多样性,作者希望未来做更动态的风格适配。
- 细粒度忠实度仍落后于人类,最常见错误是连线起止点错位或箭头方向错误,评论模型常检测不到,作者认为需提升基础模型感知能力。
- 评测依赖参考比对的 VLM 评审,结构正确性难以量化,美观等主观维度与人类偏好对齐仍不充分。
- 参考集来自 NeurIPS 2025 且限制长宽比,基准覆盖面受此约束,结论向其他会议与图表类型外推需谨慎。(解读者观点)
结论与来源
论文给出一个由检索、规划、风格、可视化、评论五个智能体组成的可复用流水线,把方法文本与图注转成学术插图,并用从 NeurIPS 2025 整理的 PaperBananaBench 做了参考比对评测。结果显示其在四项指标与总体分上超过直接提示、少样本和 Paper2Any,简洁度提升最明显,但忠实度仍不及人类,细粒度连线错误是主要失败模式;统计图改走代码路径后也有一致提升。
作者据此认为该路线可为 AI 科学家补齐可视化沟通环节。
原文与来源
AI 依据论文正文生成,经人工审核;数字与结论以原文为准。
- 感谢你赐予我前进的力量
-
 微信
 支付宝