ScaleNav:用互联网第一人称视频预训练可扩展的语言条件局部导航
ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
本文提出 ScaleNav,用无需动作标注的互联网第一人称视频学习「朝指令目标移动时画面如何变化」的导航先验,再借助少量带动作标注的仿真数据把先验转成可执行动作块,从而缓解真实机器人数据昂贵、仿真数据存在现实差距的问题。
问题与背景
语言条件局部导航要求机器人走向初始视野中可见、由文字指定的目标并停在描述位置。端到端策略需要覆盖多样真实场景的训练数据,但真实机器人动作数据采集成本高,仿真动作数据又存在仿真到现实的差距(sim-to-real gap,指仿真训练的策略迁移到真实环境时性能下降)。
互联网第一人称视频(egocentric video,即拍摄者视角的连续录像)覆盖大量真实场景与人类行走行为,是廉价的视觉经验来源,但缺少机器人动作标签。已有的利用方式多是从视频中提取估计轨迹、几何目标或潜在动作等中间监督,这些估计的误差或偏差会传导到后续策略学习;另一类视频世界模型则需要外部规划器搜索候选轨迹,预测更准不一定带来更好的导航决策。
核心思路
核心思路是把「世界模型」和「动作策略」放进同一个共享 Diffusion Transformer(DiT,一种以扩散/流匹配方式生成输出的 Transformer 主干)里联合预测:一边预测未来观测,一边预测动作块。由于两种模态共享主干参数,动作预测可以直接受益于从互联网视频中学到的视觉动态先验。
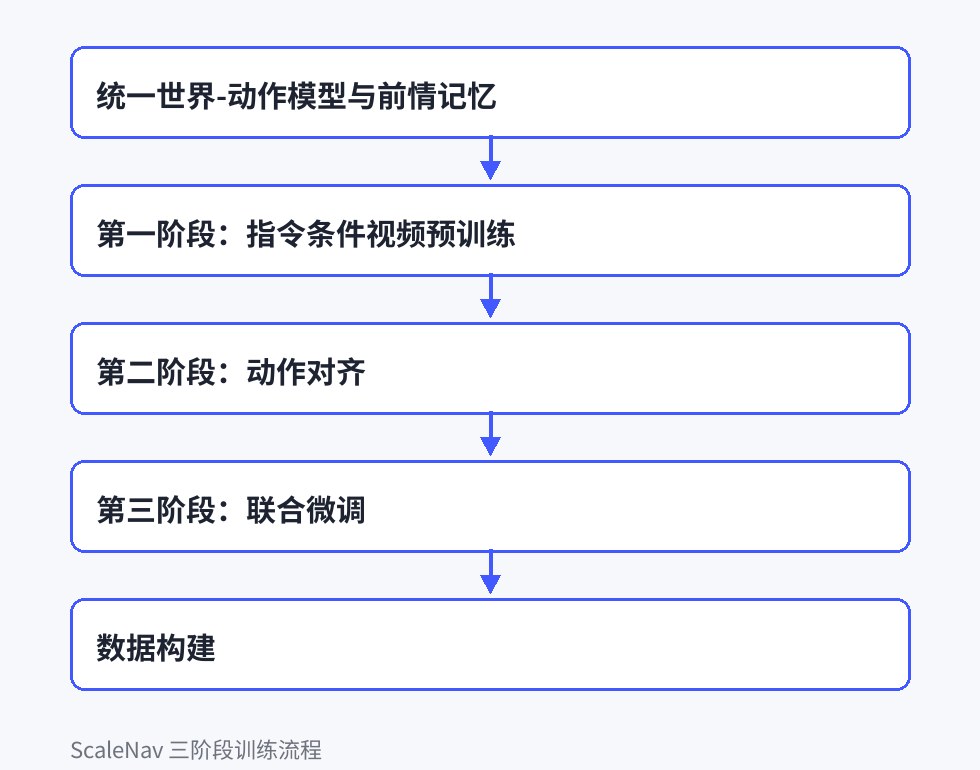
训练分三步走:先在无动作标注的互联网第一人称视频上做「指令条件视频预训练」,让模型学会「朝指令目标接近时画面如何演变」;再用带动作标注的仿真数据做动作对齐,在部分冻结的条件下训练动作头;最后联合微调全部可训练部件。推理时不需要额外规划器,模型直接从指令与观测预测一段动作块并执行,执行完再更新观测继续预测,直到到达并停止。
方法如何工作
统一世界-动作模型与前情记忆
模型以共享 DiT 为主干,把未来观测的 VAE 潜变量与动作块的归一化表示分别加噪、嵌入为 token 后拼接,由 DiT 在指令、当前观测与历史条件下联合去噪,视频头和动作头分别输出流速度。动作定义为 ,即前一帧局部坐标下的平面位移与偏航变化,T 个动作构成一个动作块。
为避免视角变化后指令所指对象失配(如「左边第二扇门」),模型始终保留初始帧 token 作为锚点,并维护最近若干个块的滑动窗口,以块级因果注意力让当前块关注这些无噪历史 token。
第一阶段:指令条件视频预训练
先沿用 Wan2.2-TI2V-5B 原有的双向文本-图像到视频形式,在互联网视频-指令对上继续预训练,再切换到块级预测:以初始帧锚点和近期视频块作为无噪历史,当前块内部保持双向注意力。该阶段只用视频流匹配损失 ,输入中没有动作 token。
论文指出通用视频模型的文本条件描述场景内容、数据准备常剔除镜头晃动素材、且整段双向生成,与导航需求不一致,因此需要这一阶段做适配。
第二阶段:动作对齐
用带动作标注的仿真数据同时预测未来观测与动作块。此阶段只训练随机初始化的动作嵌入 MLP、动作头以及共享自注意力层,其余 DiT 层冻结。
视频与动作各自独立采样噪声等级,损失为 ,其中 由当前小批量两个损失归一化得到并停止梯度。
对不完整的末段块,重复最后一帧并用零动作 补齐;视频损失用时间最大池化的帧有效性掩码排除补齐位置,动作损失仍保留零动作以学习到达后停止。同时按一定比例回放第一阶段互联网视频,仅计算视频损失以保留先验。
第三阶段:联合微调
解冻其余 DiT 模块与视频头,沿用第二阶段的联合目标,让共享表示与动作模块一起适配机器人导航。最终推理时用四个 Euler 去噪步,视频与动作的引导尺度分别为 5.0 与 1.0;由于执行动作不需要生成画面,可省略视频潜变量的 RGB 解码,并对历史 token 的键值做缓存复用。
数据构建
互联网视频方面,借助 SpatialVID-HQ 的场景标注从 YouTube 选出约 6 万段室内片段,用视觉语言模型(VLM)定位「镜头已到达可描述目标附近」的终点并回溯目标最早出现的起点,切出连续片段并生成指令,再经 VLM 复核,保留 18.2K 段导航片段。
仿真数据方面,在 Habitat-GS 与 InteriorGS 场景中用离线二维 SCAN-Planner 规划无碰撞轨迹,按 4 Hz 采样观测并由连续位姿换算动作标签,得到约 650 个场景的 2.6K 回合。两个数据集都用 VLM 改写指令以增加语言多样性。
一个例子(帮助理解,非原文实验)
以下是一个解释性示例,不是原文实验。设想机器人在客厅听到指令「走到你左边第二扇门」。它启动时先看到第一帧,画面左墙依次有一扇开着的门和一扇关着的门。模型把这一帧作为锚点长期保留,所以后续走走转转、视野改变时,「第二扇」仍以最初那帧的顺序为准,不会因为转身后顺序倒置而认错。
同时,模型根据当前画面和最近几块的历史预测未来一小段画面:门框逐渐变大、走廊向后退,这种「接近目标时画面怎么变」的直觉来自互联网第一人称视频的预训练。动作头与视频预测共享同一主干,于是把这种视觉上的接近趋势翻译成一串小位移与小转向(即动作块)。机器人执行完这一段,重新看一眼前方,再预测下一段,如此循环,直到门就在眼前,模型输出接近零位移的零动作并停下。
这个例子对应原文的初始帧锚点、历史窗口与「到达后停止」设计,但具体场景为讲解而虚构。
证据与实验
- 在 Short-Horizon OVON 的单视图适配版(524 个回合、36 个 HM3D 场景)上,ScaleNav 成功率 86.5%、SPL 71.3%,高于 NavDP、ApexNav、StreamVLN、Uni-NaVid 各变体;同协议下结论不与原三视图结果直接可比。
- 在作者构建的 HabitatGS-LN(157 个回合、45 个留出 InteriorGS 场景)上,成功率达 94.9%、SPL 86.1%,同样优于所比较的基线。
- 与不用互联网视频、直接从预训练 Wan 权重开始第二三阶段的变体相比,成功率在两个基准上分别提升 5.3 与 4.5 个百分点。
- 消融显示:用 Depth Anything 3 估计位姿得到伪动作标签并入训练只有 73.9% 成功率,低于不用互联网视频;去掉初始帧锚点成功率降到 89.8%;去掉动作对齐或去掉视频回放分别为 93.6% 与 94.3%。
- 在 Unitree Go2 上于展厅、休息区、办公区各 4 个任务、每任务 5 次共 60 次试验中,总体成功率 83.3%,高于不用互联网视频变体 65.0%、Uni-NaVid 51.7% 与 StreamVLN 41.7%。
| 指标 | 本文 | 对比/基线 | 数据集 | 条件 | 单位 | 来源 |
|---|---|---|---|---|---|---|
| 成功率 SR | 86.5 | 79.6(StreamVLN 微调) | Short-Horizon OVON 单视图适配 | 闭环评估,200 步预算 | % | §4.1 Simulation Experiments「Ours 86.5 71.3 94.9 86.1 76」 |
| SPL | 71.3 | 68.1(Uni-NaVid 微调) | Short-Horizon OVON 单视图适配 | 闭环评估,200 步预算 | % | §4.1 Simulation Experiments「Ours 86.5 71.3 94.9 86.1 76」 |
| 成功率 SR | 94.9 | 82.8(LocateAnything + NavDP) | HabitatGS-LN | 闭环评估,200 步预算 | % | §4.1 Simulation Experiments「Ours 86.5 71.3 94.9 86.1 76」 |
| SPL | 86.1 | 80.8(不用互联网视频变体) | HabitatGS-LN | 闭环评估 | % | §4.1 Simulation Experiments「Ours (w/o Internet videos) 81.1 65.5 90.」 |
| 不含互联网视频的成功率 | 86.5 | 81.1 | Short-Horizon OVON 单视图适配 | 消融对照 | % | §4.1 Simulation Experiments「Ours (w/o Internet videos) 81.1 65.5 90.」 |
| 单次执行动作的摊销推理延迟 | 76 | 184(LocateAnything + NavDP) | Short-Horizon OVON / HabitatGS-LN | RTX 4090 | ms | §4.1 Simulation Experiments「LocateAnything + NavDP 74.4 37.2 82.8 61」 |
| 总体成功率 | 83.3 | 41.7(StreamVLN 微调) | 真实机器人三环境 | Unitree Go2,60 次试验 | % | §4.3 Real-Robot Deployment「Ours 85.0 85.0 80.0 83.3」 |
| 每块策略调用延迟(四步去噪) | 684 | 1791(未优化) | 记录的观测数据 | RTX 4090,BF16 | ms | §Appendix B Implementation Details「4 1791 684 2.6 \times」 |
各行数值来自标注章节的原句,以原文为准。
适用场景与局限
适用于「目标在初始视野中可见、需按自然语言描述走到并停下」的室内局部导航,尤其适合作为长程任务中高层规划器拆出的短程子目标执行器;也适合真实动作数据稀缺、但有大量第一人称视频可用的场景。方法对硬件要求不高:模型只需要单目 RGB 与语言指令,推理在单张 RTX 4090 上约 76 ms/动作,部署在 Unitree Go2 上由机载相机采集、远端推理。
由于指令以初始观测为参照,适合「左边第二扇门」「打印机下方的柜子」这类带顺序、属性或空间关系的描述。若任务需要室外环境、区域级目标、目标初始不可见需主动搜索,或需要跨楼层长程规划,则不在已验证范围内。
- 定量评估集中在室内、目标初始可见的对象级导航;室外环境与区域级目标的泛化尚未评估。
- 互联网视频依赖视觉语言模型定位终点、回溯起点并生成/复核指令,自动标注的偏差可能带入训练;论文对此仅做了 VLM 复核而未报告人工复核的量化比例。(解读者观点)
- 动作标注全部来自仿真轨迹,仿真到现实的差距依然存在,而真实机器人试验每个方法仅 60 次、每任务 5 次,统计功效有限,且成功判定为人工评估。(解读者观点)
- 仿真推理中执行的是模型预测的动作历史而非实测位移,真实部署才使用本体里程计,两者执行条件并不完全一致。(解读者观点)
结论与来源
作者结论是:ScaleNav 通过互联网第一人称视频预训练获得导航先验,并经动作对齐与联合微调转成可执行动作块;仿真实验支持互联网视频带来的收益以及在成功率与路径效率上优于所比较方法的结论,真实四足机器人实验进一步支持其向真实导航的泛化(第 11 节)。
解读上需注意:提升主要来自与自身变体的对照,基线中 NavDP 与 ApexNav 使用真值深度且经目标定位模块改写,横向比较条件并不完全对等;两个基准的成功率均为该评估协议下的数字。
原文与来源
AI 依据论文正文生成,经人工审核;数字与结论以原文为准。
- 感谢你赐予我前进的力量
-
 微信
 支付宝