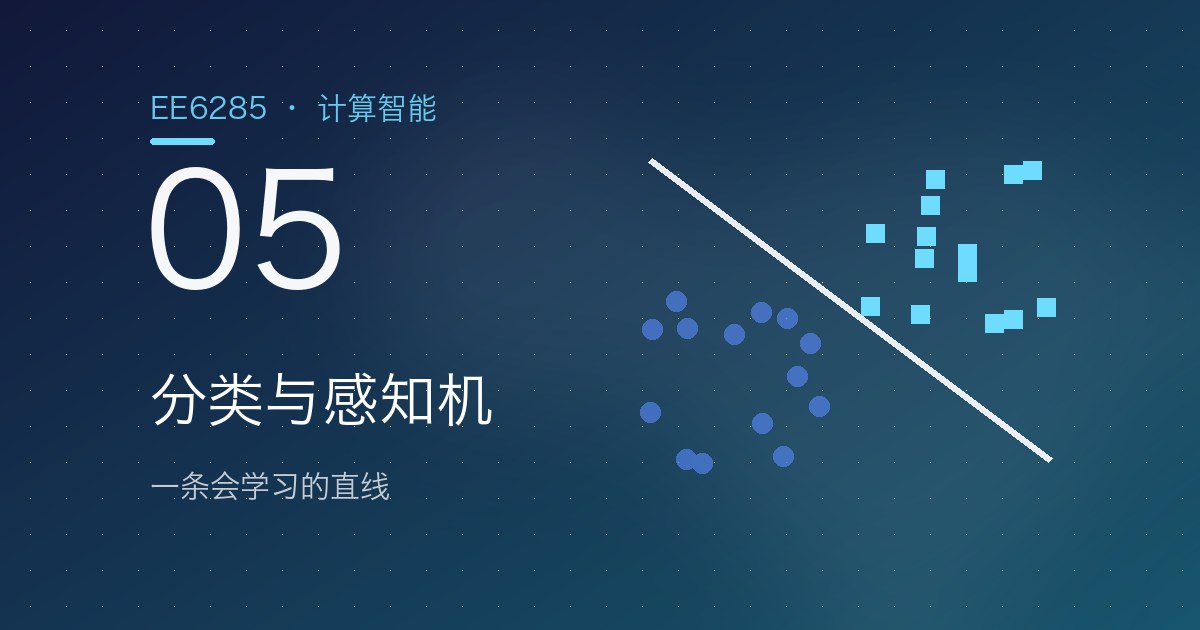
第5章:分类与感知机——从特征向量到一条会学习的直线
神经网络部分先要回答一个朴素的问题:如何把一个对象变成数字,再根据这些数字判断它属于哪一类?本章沿着“特征 → 神经元 → 决策边界 → 权重学习”展开。学完后,应能从权重写出直线方程、从两个类别的均值求分类器,并手算感知机的一次更新。
资料范围:课程文件名主要为 EE4285,本系列按用户提供的 EE6285 文件夹整理。本章页码均指 PDF 的物理页序;例题注明“教学例”时,数值是为解释公式而自设,不冒充原题或实验结果。
1. 分类究竟在学什么
模式分类(pattern classification)把输入向量映射到离散的类别标签。一个样本可写成 ;每个分量是一个特征(feature),监督学习还配有目标值 。例如垃圾邮件分类中,可把关键词频次、链接数等组成向量,标签用 表示垃圾邮件、 表示正常邮件。人脸识别可讨论眼间距、脸部比例等手工特征,也可从图像学习特征;关键不是“特征越多越好”,而是表示能否保留区分类别的信息。[NN1,PDF pp.18–19、37–39、44;TN1 Q1–Q4;SN1 pp.7–12]
分类与回归(regression)的区别在于目标:预测类别是分类,预测连续数值是回归。几何上,分类是在特征空间中划分区域;二维特征对应平面上的点,一条直线能分开的任务是线性可分任务,必须借助弯曲边界的任务则需要更丰富的模型。神经网络的重要能力是用隐藏层实现非线性映射。[NN1 pp.43–45;SN1 pp.1–4、9–10]
监督学习(supervised learning)使用输入和目标的配对;无监督学习(unsupervised learning)没有目标标签,按样本本身的结构组织数据。训练集用来调权重,验证集用来选择超参数或停止时机,测试集用于最终评估。不能一边反复查看测试准确率选模型,一边又把它称为完全独立的最终评价。训练误差小、测试误差大提示过拟合;两者都大可能与欠拟合、特征或优化问题有关。[NN1 pp.29–42;最后一句为对数据分工的教学说明]
2. 一个神经元的完整计算
本章把偏置放在权重向量的最后一个位置,和 NN2 的矩阵表达保持一致:
先计算激活信号(activation signal),再通过激活函数得到输出:
偏置 也是需要学习的参数,对应固定输入 ;它不是额外的一项真实观测特征。本课程常用双极性二值激活(bi-polar binary):
因此 时输出 。单极性二值激活则把负半轴的输出改为 。二者不能混用:使用 标签时,应检查题目是否明确采用双极性函数。[NN2 pp.3–6、13–15、30–31]
单个阈值逻辑单元(threshold logic unit,TLU)的决策边界是 。对于两个特征:
若 ,可写成 ;若 且 ,边界是竖直线,不能除以零。向量 决定法向方向,偏置决定位置。判断哪一侧为 ,最稳妥的方法是代入一个测试点计算 。[NN2 pp.32–35;斜率形式为直接代数变形]
算例1:读懂权重与边界(教学例)
给定 。
- 激活为 ,边界为 。
- 对 ,,故 。
- 对 ,,故 。
- 对 ,,按课程约定仍输出 。
若把全部权重乘以正数 ,直线和分类结果不变;乘以 ,直线位置不变,两个开半平面的标签交换,但边界本身仍按 输出 。所以“画出同一条线”不足以证明分类器相同,还必须检查方向。[基于 NN2 pp.31–35 的教学推导]
3. 方法一:最小距离分类
最小距离分类(minimum-distance classification)用每个类别的均值作为原型(prototype)。令正类均值为 ,负类均值为 ,选择欧氏距离较近的原型。若将距离相等时分给正类,则正类条件为:
展开两边,消去共有的 ,再除以 ,得到:
因此一个实现该规则的神经元可以取:
这里的距离不包括人为添加的偏置坐标;均值和原型应从原始特征计算。该公式实现的是最近均值规则,并不保证对任意分布都最优。若各特征量纲差距很大,欧氏距离会被数值尺度较大的特征主导,是否标准化必须在建模前明确。[TN2 Q2;SN2 pp.10–14;量纲说明为该距离公式的直接含义]
算例2:由样本求均值,再求分类器(教学例)
正类样本为 ,负类样本为 。
首先计算均值:,。然后得到:
最终边界为 。对待分类点 :
预测为 。用距离复核:到正类均值的平方距离为 ,到负类均值的平方距离为 ,结果一致。两原型中点 代入得到 ,也验证了边界确实是两原型连线的垂直平分线。[基于 TN2 Q2 的教学例]
4. 方法二:感知机从错误中更新
感知机学习规则(perceptron learning rule)逐个处理训练样本。按本课双极性编码,更新公式是:
其中 为学习率, 是目标, 是当前预测。由于错分时 ,前面的 使更新幅度变成 :预测正确时不更新,正类错判为负类时加上 ,负类错判为正类时减去 。NN2 给出一般学习率范围,Tutorial 3 明确要求 ,做该题应服从题设。[NN2 pp.38–42;TN3 Q1–Q2]
算例3:一次更新必须把偏置一起算(教学例)
沿用 Tutorial 3 的初始形式 、,但另取教学样本 。这不是 dataset3 的原始数据行。
先前向计算:,所以 ,发生错分。再更新:
更新后对同一点,,预测改成正确的 。注意偏置由 变成了 ;只更新前两个分量会做错。下一样本必须使用新的权重,这正是顺序学习与一次批量更新的区别。[TN3 Q1;SN3 p.2;计算为教学例]
一轮训练(epoch)是训练集中的每个样本使用一次。TN3 Q2 要求每轮把学习率减半,故第 轮 :前四轮为 。学习率变小后权重可能看起来稳定,但稳定不自动等于零分类误差或最佳测试表现。不能把“多训练几轮”当作解决不可分数据的通用办法。[NN2 pp.41–42;TN3 Q2;SN3 pp.7–14]
课件中的一个数值细节值得检查:NN2 p.44 给出初始权重 ,输入 ,。按更新式可得 ,近似吻合 p.45 的最终行;但 p.45 中间代入行写出的旧权重与 p.44 不一致。学习时应以同一组初值重新计算,避免把排版问题记成公式。[NN2 pp.44–45,已核对原页]
5. 从课堂练习走向答题
TN1 Q1–Q4 对应概念题:解释分类、特征向量、为何需要非线性网络以及带标签数据。TN2 Q2 对应推导题:必须写出平方距离展开,不能只背最终权重。TN2 Q3 要求以 70%/30% 划分训练和测试,再分别报告准确率;TN3 Q1–Q2 则要求感知机训练及学习率比较。当前资料目录未提供题目提及的 dataset1、dataset3 原始 MAT 文件,因此本章不声称复现这些题的完整训练结果。[TN1;TN2 pp.1–2;TN3 p.1]
准确率公式为 ,错误率为 。例如 SN3 p.14 报告训练错误 、测试错误 ,相应准确率分别约 和 。这是对资料给定计数的换算,不是本次重跑所得。[SN3 p.14]
最常见的失分点有四个:偏置位置抄反;把边界上的输出写成 ;双极性标签套用缺少 的另一种更新约定;只画直线而不标正负侧。只要每道题先写清 、 和 ,这些错误大多可以避免。[本章公式汇总]
6. 自测与答案
题1。 ,对 输出多少?若全部权重乘以 呢?
答案: 激活为 ,两次都输出 。
题2。 原型 、,求分类器。
答案: 权重 ,边界 ,右侧及边界预测为正类。
题3。 ,求更新量。
答案: 。
题4。 把每轮学习率减半,是否可以仅凭权重变化很小证明泛化很好?
答案: 不可以。小变化可能只是步长很小;仍需用未参与训练和选择的测试数据评估。
本章资料
- NN1:
EE4285-NN1.pdf。 - NN2:
EE4285-NN2.pdf。 - TN1 / SN1:
Tutorial-NN1.pdf/TutorialSolution-NN1.pdf。 - TN2 / SN2:
Tutorial-NN2.pdf/TutorialSolution-NN2.pdf。 - TN3 / SN3:
Tutorial-NN3.pdf/TutorialSolution-NN3.pdf。
下一章把一条直线扩展为多条边界,说明隐藏层如何把矩形、菱形和 XOR 变成可以计算的网络。
- 感谢你赐予我前进的力量
-
 微信
 支付宝