RegEx
约 25 分钟 · 示例以 Python 3.11+ 的 re 为主,JavaScript 差异单独说明
读完你能: 读懂一条常见正则;按需求一步步写出表达式;知道在 Python 和 JavaScript 里怎么调用;避开最常见的几个坑。
怎么读: 第 1–6 节是语法,按顺序读;第 7–8 节讲在代码里使用;第 9–10 节是实战和排坑;最后有速查表和小练习。
正则表达式(Regular Expression,RegEx)用一段“模式”描述文本长什么样,用来查找、校验、提取、拆分和替换文本。
读任何一条正则,都可以问五个问题:
匹配什么字符? —— 字面字符、字符类
重复几次? —— 量词
在哪里? —— 边界
怎么组合? —— 分组与分支
前后要满足什么? —— 环视
本文就按这个顺序展开。
1. 一分钟上手
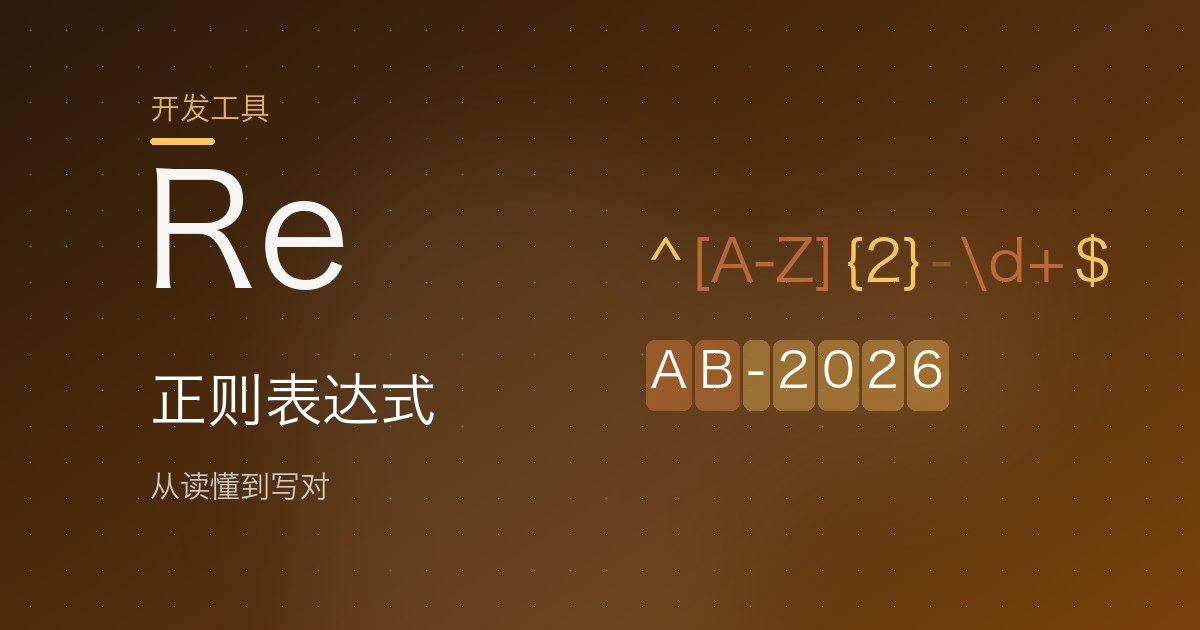
[A-Z]{2}-[0-9]{4} 的意思是:两个大写字母,一个连字符,四个数字。它能从 订单 AB-2026 已创建 中找出 AB-2026。
下面的演示框可以直接改表达式和文本,匹配结果会实时高亮。后面每学一个语法,都可以回到这里试。
交互演示加载中…(需要启用 JavaScript)
2. 匹配什么:字符与字符类
字面字符和“一个任意字符”
普通字母、数字按原样匹配:abc 匹配连续的 abc。
. 表示“一个任意字符”,但默认不包括换行。想匹配句点本身,要写 \.,例如 3\.14。
需要转义才能按字面匹配的符号有:. ^ $ * + ? ( ) [ ] { } | \。
字符类:从一组字符里选一个
常用简写:
简写比你想的宽
在 Python 中,\d 也匹配全角数字 123,\w 包括中文。只想要半角数字就写 [0-9];只想合并空格和制表符就写 [ \t]+,不要用会吞掉换行的 \s+。
import re

assert re.fullmatch(r"\d+", "123") is not None
assert re.fullmatch(r"[0-9]+", "123") is None
assert re.fullmatch(r"\d+", "123", re.ASCII) is None
assert re.sub(r"[ \t]+", " ", "a  b\tc\nd") == "a b c\nd"
assert re.sub(r"\s+", " ", "a  b\tc\nd") == "a b c d"
方括号里有几条特殊规则:
^只有放在方括号开头才表示“取反”。想匹配连字符,把它放在末尾:
[A-Z-]。.在方括号里就是句点:[.]等价于\.。[A-z]不等于“所有字母”:ASCII 里Z和a之间还夹着[、]、^、_等符号,应写[A-Za-z]。处理 Windows 换行(
\r\n)时,“非换行”要写[^\r\n]。
3. 重复几次:量词
量词只作用于紧挨在它前面的一个单位(一个字符、一个字符类或一个分组)。
ab{2} 匹配 abb,而 (?:ab){2} 匹配 abab——分组改变了量词作用的单位。
* 允许 0 次,所以 [0-9]* 能匹配空字符串。要求“至少一个数字”请用 +。
贪婪与懒惰
量词默认是贪婪的:先尽量多吃,后面对不上再一点点吐出来。在量词后加 ? 变成懒惰:先尽量少吃,不够再加。
在上面的演示框里切换“贪婪 vs 懒惰”两个示例,可以直接看到区别:
import re

text = '"red" and "blue"'
assert re.findall(r'".*"', text) == ['"red" and "blue"']        # 贪婪:一口吃到最后一个引号
assert re.findall(r'".*?"', text) == ['"red"', '"blue"']        # 懒惰:遇到引号就停
assert re.findall(r'"[^"\r\n]*"', text) == ['"red"', '"blue"']  # 更好:直接说明“引号内不能有引号”
优先写清楚“不能出现什么”
第三种写法最可靠:它不依赖贪婪/懒惰的策略,而是直接把规则写进字符类。
Python 3.11+ 还支持占有量词(*+、++)和原子组 (?>...):吃进去的字符不再吐出来。它们用来控制回溯(见第 10 节),但会改变匹配结果,不能随手把 + 换成 ++。
import re

assert re.fullmatch(r"a+a", "aaaa") is not None
assert re.fullmatch(r"a++a", "aaaa") is None
assert re.fullmatch(r"(?>a+)a", "aaaa") is None
4. 在哪里:边界
边界匹配的是位置,不消耗字符。把字符串想成一排字符,边界检查的是字符之间的“缝”。
import re

assert re.findall(r"\bcat\b", "cat scatter cat_ cat!") == ["cat", "cat"]
assert re.search(r"\Bcat\B", "scattered").group() == "cat"
assert re.findall(r"^foo", "foo\nfoo", re.M) == ["foo", "foo"]
cat_ 后面没有单词边界,因为下划线也属于 \w。
校验整串时,用 fullmatch
在 Python 中,$ 还能匹配末尾换行之前的位置,所以 ^\d+$ 会放过 "123\n"。校验整个输入时,用 re.fullmatch() 最稳妥。
import re

assert re.search(r"foo$", "foo\n") is not None   # $ 放过了末尾换行
assert re.search(r"foo\Z", "foo\n") is None
assert re.fullmatch(r"foo", "foo\n") is None      # fullmatch 严格
5. 怎么组合:分组、分支和反向引用
分支 | 的优先级最低,范围要用分组圈住:
gr(a|e)y         gray 或 grey
^(?:cat|dog)$    整串是 cat 或 dog
^cat|dog$        以 cat 开头,或者以 dog 结尾(通常不是你想要的)
import re

m = re.fullmatch(r"(?P<year>[0-9]{4})-(?P<month>[0-9]{2})", "2026-09")
assert m.group(0) == "2026-09"          # 0 号组是整个匹配
assert m.group("year") == "2026"
assert m.groups() == ("2026", "09")
assert m.groupdict() == {"year": "2026", "month": "09"}

assert re.search(r"\b(\w+)\s+\1\b", "go go home").group() == "go go"
两点经验:
分组按左括号出现的顺序编号,
group(1)才是第一个捕获组。只是为了改变优先级,就用
(?:...),避免打乱编号。分支从左到右尝试,不是自动选最长:
re.search(r"a|ab", "ab")得到的是a。
import re

assert re.search(r"a|ab", "ab").group() == "a"
assert re.fullmatch(r"a|ab", "ab").group() == "ab"
6. 前后要满足什么:环视
环视只“看一眼”前后文,不把看到的内容放进匹配结果。
import re

assert re.search(r"[0-9]+(?=元)", "价格25元").group() == "25"
assert re.search(r"(?<=¥)[0-9]+", "¥25").group() == "25"
assert re.findall(r"foo(?!bar)", "foobar foo!") == ["foo"]
assert re.findall(r"(?<![0-9])[A-Z]", "A 1B _C") == ["A", "C"]
assert re.findall(r"(?=(ana))", "banana") == ["ana", "ana"]   # 环视可找出重叠的结果
负向环视的陷阱
[0-9]+(?!元) 并不能“排除带元的金额”:在 123元 里,量词会退一步,匹配出 12(因为 12 后面是 3,不是元)。需要同时限定数字的结束位置,例如 [0-9]+(?![0-9]|元)。
Python 的后行断言必须是固定长度:(?<=ab) 可以,(?<=a+) 不行。替代方案是先匹配前缀,再取捕获组:a+([0-9]+)。
7. 标志:改变匹配规则
最常混淆的是 m 和 s:**m 管 ^ $,s 管 .**,两者互不相干。
import re

assert re.search(r"a.b", "a\nb") is None
assert re.search(r"a.b", "a\nb", re.M) is None       # m 不影响 .
assert re.search(r"a.b", "a\nb", re.S) is not None
assert re.findall(r"^cat$", "Cat\ncat\ndog", re.I | re.M) == ["Cat", "cat"]
长表达式可以用 re.X 分行写注释,可读性会好很多:
import re

order = re.compile(r"""
    (?P<prefix>[A-Z]{2})   # 两个大写字母
    -                      # 连字符
    (?P<number>[0-9]{4})   # 四位数字
""", re.X)
assert order.fullmatch("AB-2026").group("number") == "2026"
re.X 模式下空格会被忽略,要匹配空格写 [ ],要匹配井号写 [#]。
8. 在代码里使用
Python 的常用函数
import re

text = "x=12, y=34"
assert re.search(r"[0-9]+", text).group() == "12"
assert re.match(r"[0-9]+", text) is None
assert re.findall(r"[0-9]+", text) == ["12", "34"]
assert re.findall(r"([a-z])=([0-9]+)", text) == [("x", "12"), ("y", "34")]   # 有分组时返回元组
assert [(m.group(), m.span()) for m in re.finditer(r"[0-9]+", text)] == [("12", (2, 4)), ("34", (8, 10))]
assert re.split(r"[,;]\s*", "a, b;c") == ["a", "b", "c"]
assert re.subn(r"[0-9]+", "#", text) == ("x=#, y=#", 2)
实际代码中,search/match 可能返回 None,先判断再调用 .group()。
替换:模板语法和模式语法不一样
import re

assert re.sub(r"([0-9]{4})-([0-9]{2})-([0-9]{2})", r"\g<3>/\g<2>/\g<1>", "2026-09-21") == "21/09/2026"
assert re.sub(r"[0-9]+", lambda m: str(int(m.group()) * 2), "x=12 y=3") == "x=24 y=6"
JavaScript:注意 g 标志带来的状态
const text = "x=12 y=34";
const pairs = [...text.matchAll(/(?<key>[a-z])=(?<value>[0-9]+)/g)]
  .map(m => [m.groups.key, m.groups.value]);
console.assert(JSON.stringify(pairs) === '[["x","12"],["y","34"]]');

// 带 g 的正则会记住 lastIndex,连续 test() 结果会“忽对忽错”
const stateful = /a/g;
console.assert(stateful.test("a") === true);
console.assert(stateful.test("a") === false);
校验用的正则不要加 g
判断单个输入是否合法时,用不带 g 的正则,例如 /^[A-Za-z][A-Za-z0-9_]{2,15}$/.test(name)。
转义:分清“正则层”和“字符串层”
Python 用原始字符串 r"..." 写正则,就不必为字符串再转义一次:r"\d+" 和 "\\d+" 是同一个模式。
把用户输入当作普通文本放进正则时,一定先转义:
import re

keyword = "a+b.txt"
assert re.search(re.escape(keyword), "打开 a+b.txt").group() == keyword
9. 实战:先写清规则,再写表达式
写正则前,先用一句话写下规则,再逐段翻译。下面的例子都使用 fullmatch() 做整串校验。
import re

# 用户名:3–16 个 ASCII 字符;字母开头,其后只能是字母、数字、下划线
username = re.compile(r"[A-Za-z][A-Za-z0-9_]{2,15}")
assert username.fullmatch("Janus_01")
assert not username.fullmatch("1janus")
assert not username.fullmatch("Janus_01\n")

# 整数:可带正负号;不接受 01、1.0、空串
integer = re.compile(r"[+-]?(?:0|[1-9][0-9]*)")
assert integer.fullmatch("-42")
assert not integer.fullmatch("01")

# 颜色:3 位或 6 位十六进制
color = re.compile(r"#(?:[0-9A-Fa-f]{3}|[0-9A-Fa-f]{6})")
assert color.fullmatch("#3aF") and color.fullmatch("#12ab34")
assert not color.fullmatch("#12345")
日期:格式交给正则,真假交给日期库
[0-9]{4}-[0-9]{2}-[0-9]{2} 连 2026-99-99 都能通过。用正则判断大小月和闰年非常痛苦,交给标准库就好:
import re
from datetime import date

def valid_date(text):
    if re.fullmatch(r"[0-9]{4}-[0-9]{2}-[0-9]{2}", text) is None:
        return False
    try:
        date.fromisoformat(text)
        return True
    except ValueError:
        return False

assert valid_date("2024-02-29")
assert not valid_date("2026-02-29")
assert not valid_date("2026-99-99")
日志提取
import re

log = re.compile(
    r"(?P<date>[0-9]{4}-[0-9]{2}-[0-9]{2})[ \t]+"
    r"(?P<time>[0-9]{2}:[0-9]{2}:[0-9]{2})[ \t]+"
    r"(?P<level>DEBUG|INFO|WARN|ERROR)[ \t]+"
    r"(?P<message>[^\r\n]*)"
)
m = log.fullmatch("2026-09-21 09:30:05 INFO server started")
assert m.group("level") == "INFO"
assert m.group("message") == "server started"
什么时候不该用正则
邮箱:
[^\s@]+@[^\s@]+\.[^\s@]+只能粗筛,真正确认要发验证邮件。电话号码:规则因国家而异,用号码解析库。
URL、IP、JSON、HTML、CSV:都有专门的解析器,正则只适合在已知格式里定位片段。
文件扩展名:
.bashrc、archive.tar.gz各有语义,用路径库处理。
10. 两个大坑:Unicode 与回溯
Unicode 与引擎差异
不同语言的正则引擎“方言”不同,写跨语言的正则前先确认:
console.assert(/^\p{Script=Han}+$/u.test("正则表达式"));
console.assert(!/^\p{Script=Han}+$/u.test("RegEx中文"));
[一-龥] 并不是完整的汉字集合;一个“看起来的字符”(如 emoji 组合)也可能由多个码点组成,.{1,10} 不能等同于“最多 10 个字”。
回溯为什么会卡死
^(a+)+$ 遇到 aaaa…a! 这样的输入时,引擎会尝试把这串 a 拆成各种组合,次数随长度指数增长。在演示框里选最后一个示例,可以看到它被强制停止。
防范方法:
限制输入长度。
避免“量词套量词”、相互重叠的分支;能写具体字符类就写具体字符类。
测试时专门构造“前面都对、最后一个字符错”的输入。
简单任务(包含、前缀、按逗号拆分)直接用字符串函数。
这里只需要 a+,配合 fullmatch() 即可。
速查表
校验整个值用
fullmatch();查找片段用search()。^在外面是“开头”,在[^...]里是“取反”。m管^ $,s管.。*可以是 0 次,+至少 1 次。(...)捕获,(?:...)只分组。模式里反向引用写
\1;替换模板里 Python 写\g<1>,JavaScript 写$1。用户输入放进正则前先
re.escape()。格式对不等于内容对:日期、号码、URL 还要做语义校验。
小练习
先自己写,再用上面的演示框验证,最后展开答案。
1. 匹配 6 位邮政编码(只允许半角数字),整串校验。
re.fullmatch(r"[0-9]{6}", s)。不用 \d,因为它在 Python 里会接受全角数字。
2. 从 “耗时 120ms,重试 3 次,总计 480ms” 中只提取毫秒数。
re.findall(r"[0-9]+(?=ms)", text) → ['120', '480']。用先行断言要求后面是 ms,结果里不包含单位。
3. 把 “2026-09-21” 改写成 “2026年9月21日”(月、日去掉前导零)。
import re

result = re.sub(r"([0-9]{4})-([0-9]{2})-([0-9]{2})",
                lambda m: f"{m[1]}年{int(m[2])}月{int(m[3])}日", "2026-09-21")
assert result == "2026年9月21日"
需要计算时,替换参数用函数比模板更方便。
参考资料
- 感谢你赐予我前进的力量
-
 微信
 支付宝